让 Claude 提取合同字段时,把每个值的出处一起留下
Claude Citations 与严格结构化输出不能同时开启。需要提取合同字段并保留出处时,可按字段输出带引用的文本,再由程序解析、检查缺项与引用位置。
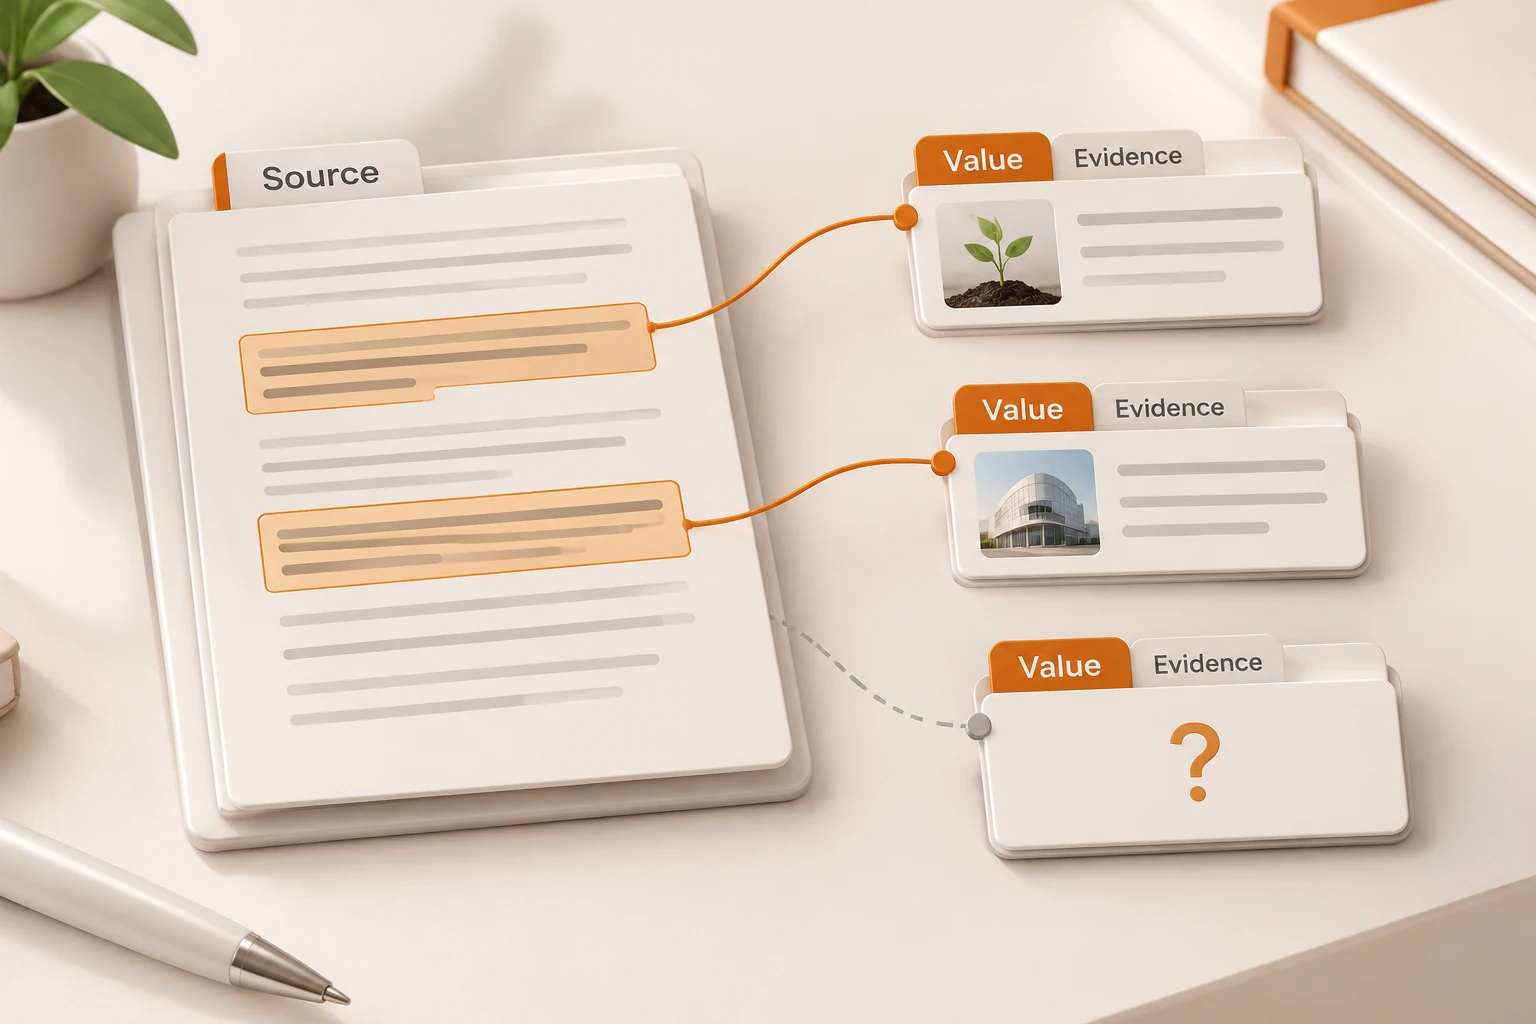
想让 Claude 从合同中提取“退货期限、定制品例外、审核时长”,还希望每个值都能点回原文,不能简单把 Citations 与严格 JSON 输出一起打开。当前 Claude API 不允许 Citations 和 output_config.format 同用,组合请求会返回 400。
官方给出的办法是让模型按字段逐行作答、每行保留引用,再由程序转成结构化记录。这样既能得到业务字段,也不会在拼接纯文本时丢掉出处。
本文于 2026 年 11 月 19 日重读 Claude Citations 指南,依据其中“Get structured data with citations”和引用位置规则编写。没有调用真实模型或上传合同;演示条款不代表法律意见或实际商业政策。
已经会输出 JSON,为什么还要另一条路径?
结构化输出解决字段和类型是否符合约定,引用解决答案能否指回提供的材料。两者用途不同,当前严格模式的接口约束也不同。
启用文档引用后,Claude 的回答可能由多个文本块组成,每个块可带 citations 数组。只取文本拼成一个字符串再做 JSON 解析,会把引用与文本之间的关系一起抹掉。反过来,即使请求没有严格 schema,只在提示词中要求“仅输出 JSON”,官方也提醒可能得到很少引用或完全没有引用。
因此有出处要求的字段提取,先按官方建议用逐行格式,接到应用后再验证字段类型。要求严格 JSON 且不需要原文定位的任务,仍可保留原来的结构化输出路径。
给模型什么样的材料和指令?
在公开演示中提供一份两条规则的文档:
未开封商品可在签收后 7 天内申请退货。
定制商品不适用上述规则,需要人工审核。
请求提取三个字段,其中审核时长在资料里根本不存在。这样能同时检查正常提取、例外规则与缺失信息。以下按当前官方示例使用 claude-opus-5-5;需要本地官方 ANTHROPIC_API_KEY,本文未执行。
import anthropic

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[{
        "role": "user",
        "content": [
            {
                "type": "document",
                "source": {
                    "type": "text",
                    "media_type": "text/plain",
                    "data": "未开封商品可在签收后 7 天内申请退货。定制商品不适用上述规则,需要人工审核。",
                },
                "title": "公开演示条款 v1",
                "citations": {"enabled": True},
            },
            {
                "type": "text",
                "text": "提取 return_window、custom_items、review_days。每行格式为 field: value,给每个有依据的值附上文档引用。没写的值填 UNKNOWN,不猜测。",
            },
        ],
    }],
)
print(response.model_dump_json(indent=2))
不要给这份请求再添加 output_config.format 或已弃用的 output_format。多份文档还需按当前指南统一启用引用,不能在同一请求里混用开启与关闭引用的文档。
一个字段被拆成几个文本块,怎么保存引用?
按响应顺序处理文本块,遇到换行才切出一条记录,并把每个块的引用挂到它实际覆盖的行上。不能假定“一块就是一行”:官方例子里字段名和字段值就分属不同块。
下面是可离线使用的解析示例,输入是保存为 response.json 的完整响应。它只接受约定字段,拒绝重复字段;缺值、UNKNOWN 或无引用的记录进入待核状态。它不会验证引用是否支持该值,后一步仍要核对原文。
import json
from pathlib import Path

payload = json.loads(Path("response.json").read_text())
lines = [{"text": "", "citations": []}]
for block in payload.get("content", []):
    if block.get("type") != "text":
        continue
    pieces = block.get("text", "").split("\n")
    for i, piece in enumerate(pieces):
        if i:
            lines.append({"text": "", "citations": []})
        lines[-1]["text"] += piece
        if piece:
            lines[-1]["citations"].extend(block.get("citations", []))

fields = {}
expected = {"return_window", "custom_items", "review_days"}
for line in lines:
    name, separator, value = line["text"].partition(":")
    name, value = name.strip(), value.strip()
    if not separator or name not in expected:
        continue
    if name in fields:
        raise ValueError(f"Duplicate field: {name}")
    fields[name] = {
        "value": value,
        "citations": line["citations"],
        "needs_review": not value or value == "UNKNOWN" or not line["citations"],
    }
for name in expected - fields.keys():
    fields[name] = {"value": None, "citations": [], "needs_review": True}
print(json.dumps(fields, ensure_ascii=False, indent=2))
业务上还要检查字段含义。例如“7 天”必须保留“未开封、签收后”的条件;把一个数字提出来,并不能把合同规则缩成这个数字。模型给缺失字段编了值,即使附上引用,也应在原文核对时被拒绝。
页码和字符位置到底从哪里开始?
官方引用位置采用不同口径,界面实现时不要共用一个“全部加一”的处理:
| 文档类型 | 位置口径 | 需要留意 |
|---|---|---|
| 页码从 1 开始,结束页不包含在范围内 | 1 到 2 只覆盖第一页 | |
| 纯文本 | 字符位置从 0 开始,结束位置不包含 | 保存送入模型的原始文本版本 |
| 自定义内容文档 | 内容块位置从 0 开始,结束位置不包含 | 保留原始块顺序与对应 ID |
所有文档的 document_index | 按请求中全部文档块从 0 编号,跨消息累计 | 不能只在最后一条消息内查找 |
PDF 引用基于可提取文字,不能引用 PDF 里的图像。title 与 context 也不属于可引用的源内容。扫描件是否提取完整,仍需先走PDF 证据链检查。
有引用就能自动通过审核吗?
不能。官方保证引用指针有效、cited_text 从源文档提取,不保证每个业务字段完整,也不保证你的解释一定正确。至少把下面几件事分开验收:
- 约定的字段是否齐全,重复与未知项有没有进入待核。
- 引用是否指向本次使用的正确文件版本与页、字符范围。
- 被引用的内容是否真支持该值,有没有漏掉否定和例外。
- 最终页面能否点开来源,应用是否保留了文本块与引用的关联。
若使用检索片段而非整份文件,要把文档标识、版本与片段一同保存;Rerank 与来源映射解释了前面一段的候选选择。使用 Nbility 前按连接基础确认模型与协议,并另外核对渠道是否保留原生 citations;普通聊天成功不能替代这项验收。