Claude Code 后台会话丢网关:2.1.326 之后先让它停下,再改配置
从 2.1.326 起,后台会话拿不到你在 shell 里导出的网关地址时,会在发请求前停下。原因在 supervisor 与配置来源,把 ANTHROPIC_BASE_URL 写进 settings.json 的 env 块才不会被环境差异吃掉,并按 /status 与 daemon status 核对。
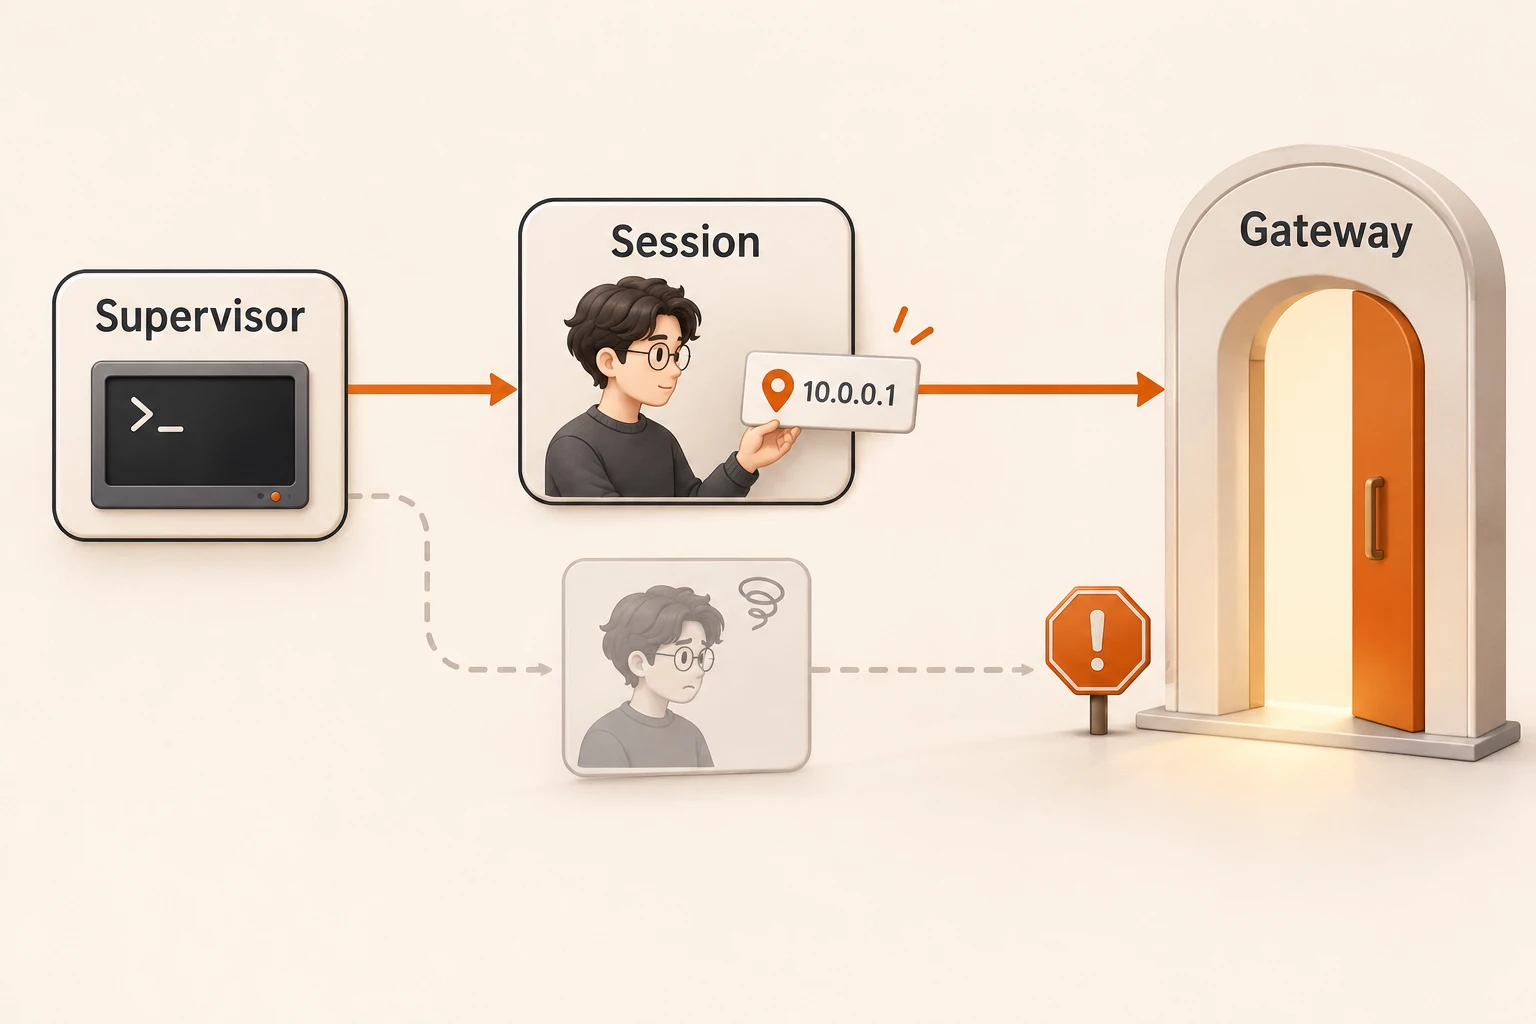
Claude Code 在 2026 年 11 月 16 日发布的 2.1.326 修了一个容易花错钱的问题:后台会话丢了你在 shell 里导出的网关(ANTHROPIC_BASE_URL),以前会继续跑,现在会在发出任何模型请求之前停下并说明原因。
会触发这段逻辑的情况有三种:后台服务崩溃重启后、从另一个文件夹重新打开会话时,以及后台服务本身没有这个变量的环境。它不会替你猜一个地址,也不会悄悄换回其他登录方式。
本文依据 2.1.326 的 CHANGELOG、agent view 文档、连接 LLM 网关与错误说明,核对于 2026 年 11 月 17 日。我没有复现崩溃或跨目录重开,也没有在你机器上运行这些命令;下面的判断来自官方文档,验证步骤留给你按实际情况执行。
谁在发请求:前台会话与后台会话不是一回事
直接在终端里运行 claude,进程属于这个终端,关掉终端它就结束了。而 agent view 里列出的会话都叫后台会话,由一个叫 supervisor 的后台服务托管,所以关掉窗口后还能继续跑。/status 的 Session kind 一行会区分:后台会话显示 background job · attached 或 background job · unattended,其他会话显示 interactive。
这个区别正是问题来源。supervisor 只在第一次把会话转入后台或打开 agent view 时启动,之后每个会话都是它自己的 Claude Code 进程,由 supervisor 派生。你在某个终端里 export 的变量,只存在于那个终端以及从它启动的子进程里;supervisor 当初不是从那个终端起来的,后来的会话进程就拿不到。
来自用户的报告能看到同样的形态。GitHub 上的 #87255 记录的是 Vertex 网关:daemon 继承了完整环境,但真正跑会话的 worker 少了 ANTHROPIC_VERTEX_BASE_URL 和 CLAUDE_CODE_SKIP_VERTEX_AUTH,于是每次请求都报 Could not load the default credentials。维护者在 2026-11-14 标记它已在 2.1.251 修复。另一条 #66014 讲的是反过来的一件事:在 agent view 里来回切换,会话可能继承到别的会话的 ANTHROPIC_* 变量,把模型别名悄悄换掉。两者结论一致——后台会话的环境来源不只有你的当前终端。
只在 shell 里 export,什么时候能带过去
文档列得很具体:shell 导出的网关地址,只有在 supervisor 本身也是从导出同一网关的 shell 启动时,才会被转发给后台会话,而且只在下面四种情况:
| 你做的动作 | 是否沿用 shell 导出的网关 |
|---|---|
用 ← 或 /background 把当前会话转入后台 | 是 |
| 把新会话派发到当前所在目录 | 是 |
| 在当前目录里附着或回复,唤醒已停止的会话 | 是 |
在当前目录用 claude respawn 重启会话 | 是 |
| 派发到别的目录、从别的目录附着唤醒、后台服务崩溃后由服务重启 | 不保证,会停下并提示 |
也就是说,单机单目录的小范围使用,export 可能一直好用,问题只在换目录、重开、崩溃后重启时才出现——恰好是你最不容易留意的时候。
2.1.326 改了什么
官方条目写的是“后台会话在崩溃后、从另一个文件夹重开后,或后台服务本身缺少网关时丢掉 shell 导出的网关,现在会在发出任何模型请求之前停下”。
这里要克制:条目没有写旧版本会把这些请求发到哪里。能确定的是它不再带着一个缺失的网关继续跑;至于是直接失败还是落到别的认证路径,取决于当时的登录方式和版本,我不替你推断。
对使用网关的人来说,这个变化把“费用跑到你没预期的入口”变成一次可以读懂的停止,代价是要自己去补配置。这个已知错误在更早的版本里就已经有名字:No LLM gateway: a gateway set in your shell isn't passed to a session opened from another folder。在 2.1.302 之前,同样的情况下会显示 Not logged in · Please run /login,连是哪个文件夹的问题都不说。
改法:把网关写进 settings.json 的 env 块
官方建议很直接:任何需要后台会话稳定走网关的配置,放进 settings 文件的 env 块,而不是依赖 shell。同一个变量在 shell 和 settings 文件里都设置时,settings 文件里的值生效,因为它会被写进进程环境,覆盖继承来的值。
用户级文件 ~/.claude/settings.json 对所有项目生效:
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.nbility.ai",
    "ANTHROPIC_AUTH_TOKEN": "YOUR_API_KEY",
    "ANTHROPIC_MODEL": "claude-sonnet-4-6"
  }
}
只影响一个项目时,写 .claude/settings.local.json,它由 Claude Code 自己创建时会保持不进 Git。不要把 Key 放进项目里被提交的 .claude/settings.json——那份文件会随仓库分发给每个克隆的人。
凭据本身还有更稳的做法。Key 会轮换或来自密码库时,用 apiKeyHelper 指向一个只往 stdout 打印 Key 的脚本,避免明文长期留在配置文件里。ANTHROPIC_AUTH_TOKEN 走 Authorization: Bearer,ANTHROPIC_API_KEY 走 x-api-key;两者的差别在 Nbility 这类兼容服务上只要选错就会得到 401,Claude Code 接入第三方 API里已经逐项讲过。
如果你的网关配置已经在哪些文件里、能不能被后台会话读到还没把握,先别急着搬全部变量。2.1.326 同一次更新里,/status 新增了一行说明“你的 provider 或某个环境变量关闭了哪些功能”,配合 Auth token、API key 与 Base URL 几行,可以判断当前会话到底在用哪个地址和哪种凭据。改完配置后对照这几行,比看 echo $ANTHROPIC_BASE_URL 有用得多。
改完怎么确认
- 在一个新终端里启动
claude,运行/status,确认 Base URL 是你配置的网关,Auth token 或 API key 一行点名的是ANTHROPIC_AUTH_TOKEN、ANTHROPIC_API_KEY或apiKeyHelper。出现Login method且指向 claude.ai 账号,说明凭据没送到。 - 发一条不读文件的短消息,确认能正常回复,再接后台。
- 用
←或/background转入后台,打开 agent view,附着回去再发一条。 - 到另一个目录执行一次
claude attach或claude respawn <会话 ID>,再看/status的Base URL是否仍是网关。这一步最容易暴露问题,也正是旧版本会出事的路径。 - 需要确认后台服务本身的状态时运行
claude daemon status,它会报告 supervisor 是否可达、进程 ID、版本、socket 目录和在线会话数。
遇到这两个报错分别怎么办
No LLM gateway: opened from another folder · respawn from ~/project 的意思是:你在另一个文件夹派发、唤醒或重启了这个会话。两条路:
- 网关在 settings 文件里:在任意目录运行
claude respawn <id>即可,重启的会话会读取~/.claude/settings.json或该项目下的.claude/settings.local.json。 - 网关只在终端里 export:先在该终端
cd到提示里写的目录,再运行claude respawn <id>;如果 supervisor 不是从这个终端起来的,还要先重启 supervisor,再重新执行。
Could not resolve authentication method 出现在派发阶段、而交互会话正常时,说明收到任务的 worker 没拿到凭据——后台会话的凭据来自 supervisor。可以这样重启它:
claude daemon stop --any --keep-workers
大约一分钟内运行 claude agents 或 claude --bg 启动新的 supervisor。如果你用的是 ANTHROPIC_API_KEY 这类环境变量而不是 /login,这条命令要在设置了该变量的终端里执行。
几个容易被忽略的边界
- 版本对不上:
claude daemon status会提示正在运行的 supervisor 版本和当前claude版本不一致,这通常发生在自动更新之后。需要时运行claude daemon stop --any让 supervisor 换成新版本;2.1.326 的修复要生效,运行的必须是更新后的版本。 - supervisor 自己停了:在 macOS 和 Linux 上,如果 supervisor 被外部结束,会话大约一分钟后停止,保存的对话还在磁盘上,重新附着即可恢复。
- 想彻底不用后台:设置
disableAgentView: true或CLAUDE_CODE_DISABLE_AGENT_VIEW。有会话一直被另一个会话的 provider 环境带偏时,这是最省事的隔离办法;#66014 里也有人这么做。 - 云厂商网关:如果你不用
ANTHROPIC_BASE_URL,而是通过CLAUDE_CODE_USE_VERTEX加ANTHROPIC_VERTEX_BASE_URL、CLAUDE_CODE_SKIP_VERTEX_AUTH走云厂商前面的网关,它们会被当作一对转发;但 shell 里残留的变量同样可以用env块里的空字符串覆盖,例如"CLAUDE_CODE_USE_VERTEX": "",Claude Code 会当作未设置。 - 非必需流量:网关只承载模型请求。连接网关的文档说明版本检查、遥测等项目会发往别处;网络只允许出网关时,在同一个
env块里加上CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC。
对用 Nbility 跑后台任务的人来说
把 ANTHROPIC_BASE_URL 指向 https://api.nbility.ai 时,后台会话能不能拿到这个地址,直接决定你的用量记在哪个账号上。放进 env 块的含义是:从哪个目录派发、会话被重启几次,路由都一样。这比在每个终端里重复 export 稳,也省掉了“这台机器忘了 source 哪个 profile”的排查。
需要连回国内网络时,先把网络层和配置层分开查,把 Claude Code 带回国列的是另一条路径;本文只处理网关地址为什么没送到后台会话。
FAQ
升级到 2.1.326 后一定要改成 settings.json 吗? 不是。只在一个目录里交互使用,shell export 仍然有效。经常派发到其他目录、经常让会话在后台跑,才值得搬进 settings 文件。
shell 和 settings.json 都设了同一个变量,用哪个? 绝大多数会话用 settings 文件里的值。少数变量有例外,以 env 变量文档为准。
后台会话停在 No LLM gateway,对话会丢吗? 对话保存在磁盘上,按提示在正确目录运行 claude respawn <id> 会从保存的对话继续,不需要重跑已经完成的工作。
它会在半夜自动跑任务时悄悄花到别的账号上吗? 这次修复的作用正是让它在发请求前停下,而不是带着缺失的网关继续跑;但你仍应把网关写进配置,并定期用 /status 核对一次。