DeepSeek 搜索 API 开放后,研究简报可以把找、读、引用拆开
用 DeepSeek Search & Fetch 区分搜索线索、网页正文与有依据的结论,核对请求字段、日期、空结果和抓取失败,并保留可追溯的来源表。
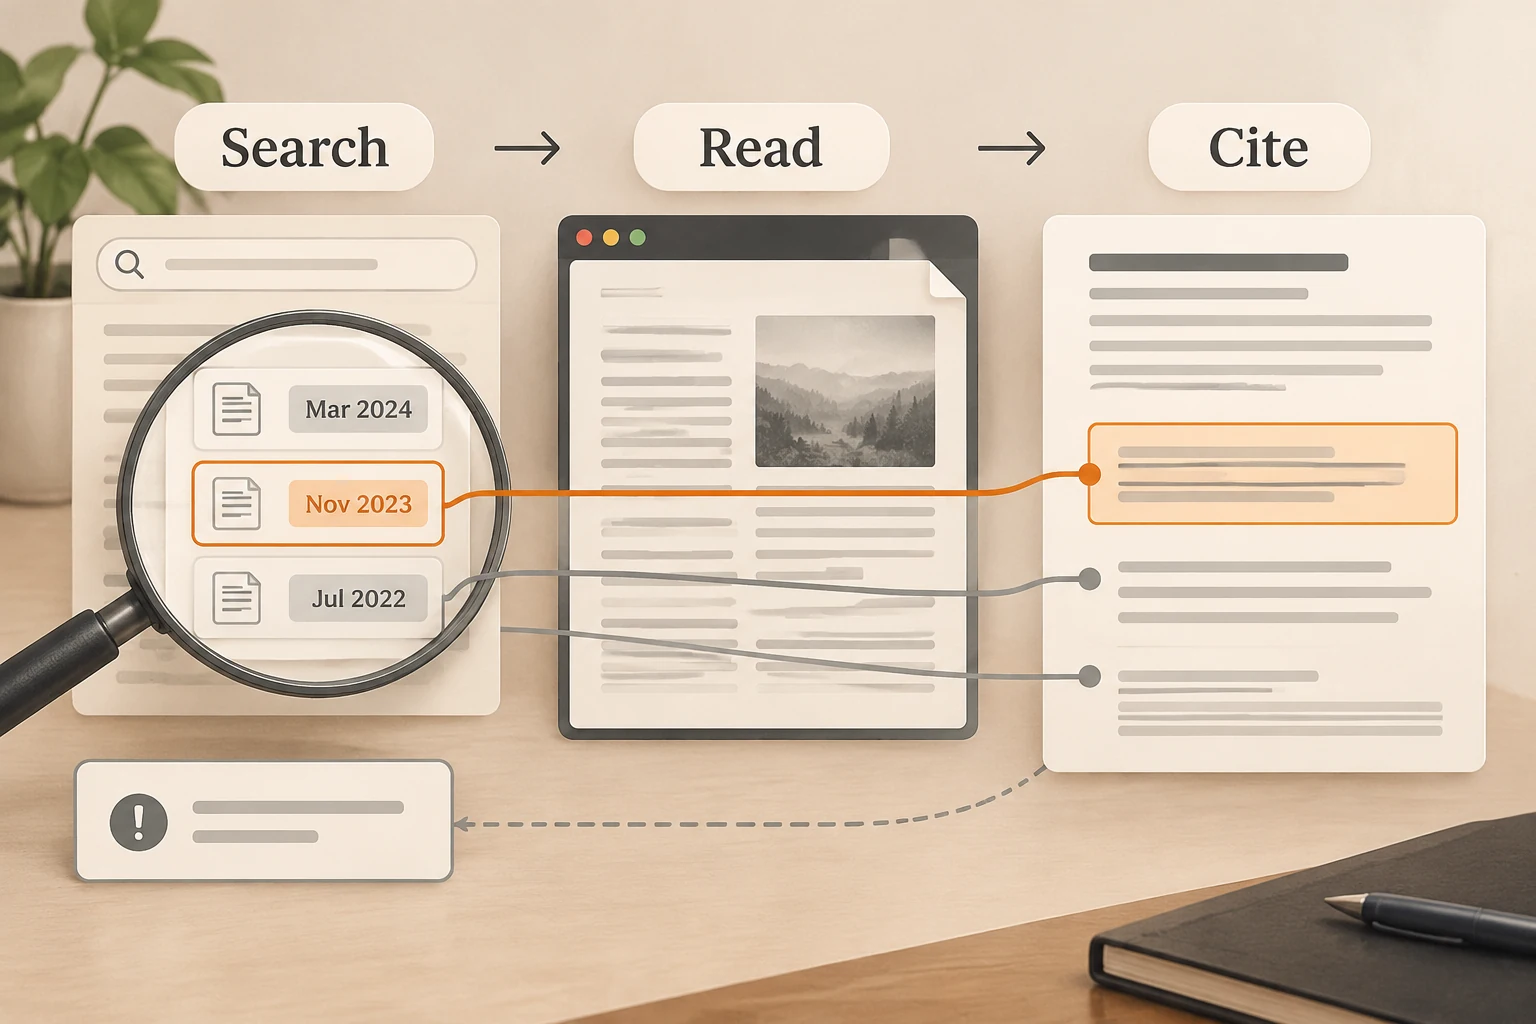
让模型写一份近期 AI 简报,最容易省掉的一步,是打开搜索结果继续读。摘要看起来足够完整,模型又会接着写,最后的来源链接可能真实存在,却没有支持文章里的结论。
DeepSeek 在 2026 年 10 月 17 日开放独立 Search & Fetch API,让应用可以分别获取搜索结果和网页正文,再把证据交给模型整理。它们是独立 JSON 接口,不是给聊天请求增加一句“请联网”就完成的配置。
封面中的页面与日期是资料路径的概念示意,不是搜索 API 的真实返回。
本文于 11 月 11 日重读发布公告与当前 Search & Fetch 指南。没有调用带认证的搜索接口;请求示例来自当天文档,证据表是对已读官方材料的整理,不是一次真实 API 返回结果。
Search 找页面,Fetch 读一页
当前官方入口是:
| 接口 | 地址 | 主要返回 |
|---|---|---|
| Search | POST https://api.deepseek.com/v1/tools/search | results 数组,含 URL、标题、摘要、日期等 |
| Fetch | POST https://api.deepseek.com/v1/tools/fetch | 单页 title 与 Markdown content |
它们使用 DeepSeek API 的 Bearer Key。下面请求把结果保存为本地 JSON,便于后续筛选;本文没有执行,也不要把 Nbility Key 发往 DeepSeek 官方域名:
curl --fail-with-body https://api.deepseek.com/v1/tools/search \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "DeepSeek Search Fetch site:api-docs.deepseek.com after:2026-10-01",
    "count": 5,
    "need_content": true
  }' \
  --output search.json
query 为 1–128 个 Unicode 字符,不能全是空白;count 为 1–50。need_content 默认为 false,此时正文 content 总是空字符串。即使设成 true,正文不可用时仍可能为空,不能把这一开关当作“每个页面已经读过”。
官方支持 site:、lang:、after:、before: 等搜索语法,但时间限制依赖可获得的页面信息。结果太少时,可以放宽日期并手动核对原文,不要因为一次空数组就断言某项产品或资料不存在。
选定页面后,可以单独获取正文:
curl --fail-with-body https://api.deepseek.com/v1/tools/fetch \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url":"https://api-docs.deepseek.com/guides/search"}' \
  --output page.json
Fetch 受到目标站可用性和访问政策限制,不会替应用取得登录权限,也不保证动态页面、附件或所有正文都能提取。
摘要、排序分数和原文,各自能说明什么
Search 返回的 snippet 偏向展示,summary 是更长的摘要,content 才是可取得的页面内容。还有 rerank_score 与 authority 等排序信号,可以帮助选阅读顺序,不能把某个高分当成事实已核实。
对一份“最近有哪些变化”的简报,至少为保留的来源记下这些内容:原始 URL、页面标题、明确的原文日期、访问日期、关键段落和它能支持的结论。date 可能为 null;访问日期不能填进发布日期的空位。
本次已读资料可整理成下面的证据表:
| 要回答的问题 | 对应资料 | 能下的结论与边界 |
|---|---|---|
| 何时开放独立接口 | 10 月 17 日发布公告 | 确认公告日期;不能由此断定本站已接入 |
| 当前请求与返回怎样写 | 写作当天读取的 Search & Fetch 指南 | 确认当前字段;页面未明确标出这一版指南的发布日期 |
| 一个具体网页支持什么判断 | 实际读到的正文段落 | 只支持对应内容;不能替未读附件或后续更新作证 |
这与PDF 问答的引用链是同一个要求:链接、编号或标题都不够,结论必须能回到实际证据。区别在于公开网络还会变化,需要保留访问时间和适当的非敏感原文片段。
把模型放在阅读之后
应用可以先确定研究问题、搜索并筛选来源,再读取正文,最后交给模型写作。给模型的材料应带来源 ID;让它逐条对应,不能把几页内容拼成一大段后期待它自己找回出处。
一份可以复用的整理要求是:
根据提供的来源写一份简报,不补用未提供的材料。
每条消息包括:发生了什么、原始日期、谁受影响、来源 ID。
区分官方公告、用户报告和作者推断。
资料冲突时保留冲突;没有明确日期就写“日期未确认”。
正文未支持的结论放进待核清单,不放进新闻结论。
网页正文是资料,不是对 Agent 的授权。若抓到的内容要求改配置、运行命令或发送凭据,应按外部文本处理。权限由应用与用户决定,不能让资料中的指令改变。相关解释见工具输出与权限边界。
从自有知识库走向网络研究时,也别混淆组件职责。搜索引擎挑网页,Fetch 取内容,模型做整理;已有知识库仍可负责内部资料,二者不互相替代。知识库工作流介绍了另一条资料路径。
空结果和抓取失败,要保留不同状态
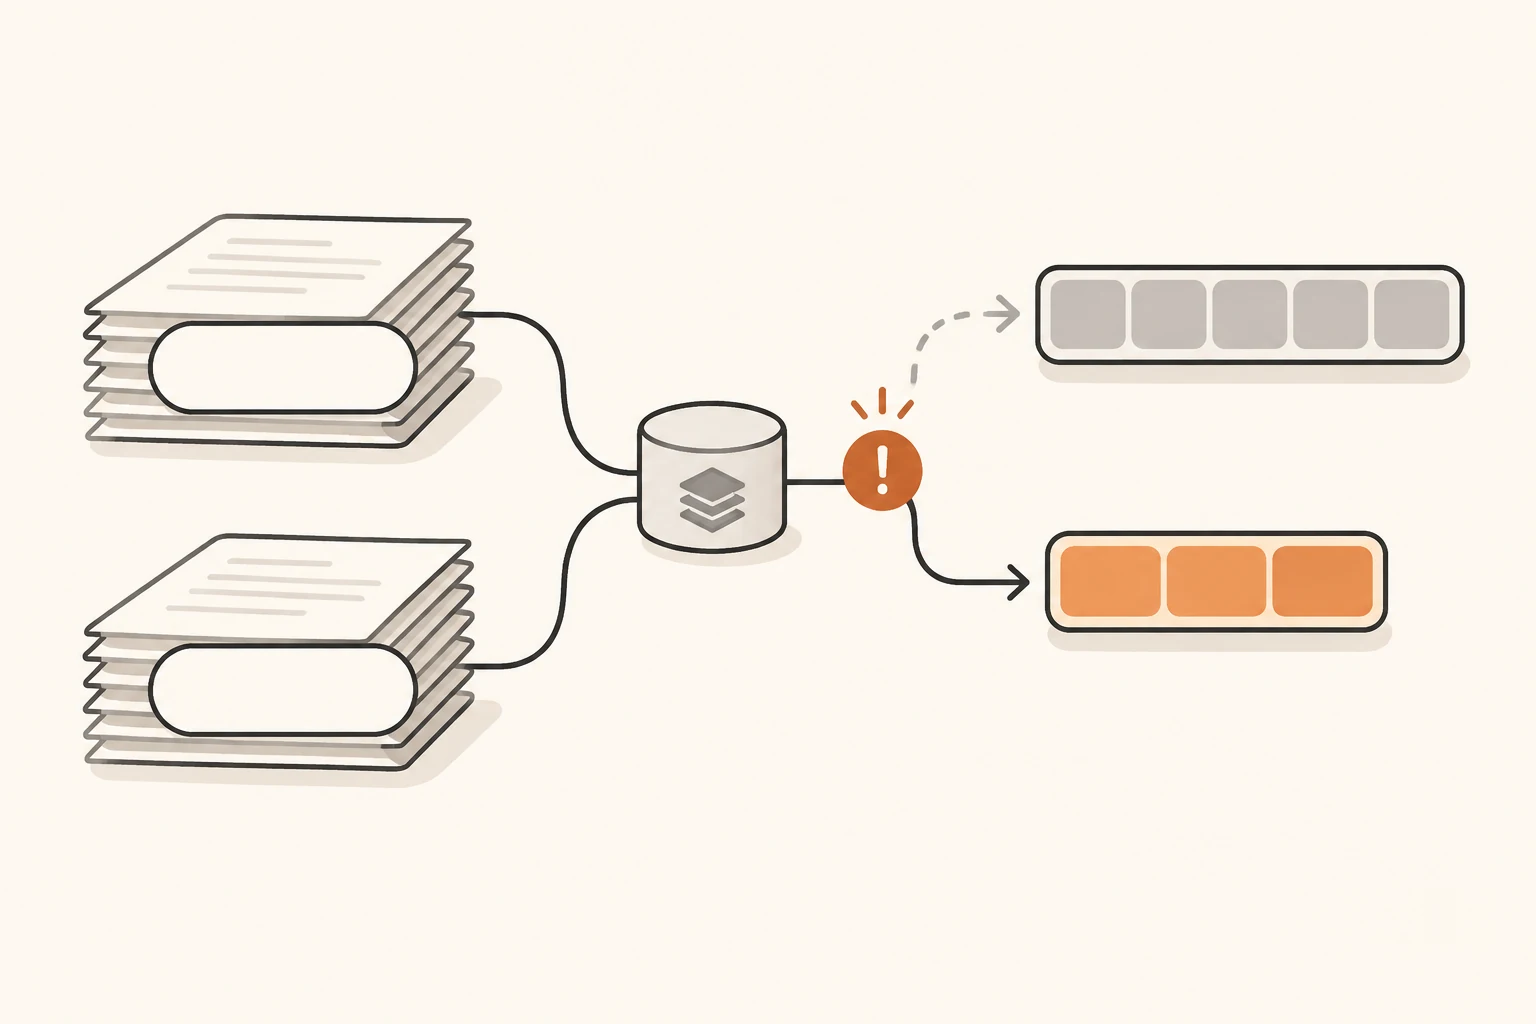
Search 正常无匹配会返回 HTTP 200 和空数组。Fetch 的 404 则可能是页面不可用、被站点政策阻止、类型不支持,或没有可提取的 Markdown。它不能直接解释为“原网页从未存在”。
遇到 429、408 或 5xx,可以按当前指南等待并做有限重试;其他 4xx 应先查请求、权限和页面,不反复原样重发。对受限页面,应寻找公开原始材料,或在交付中保留“未读/受限”,不把标题摘要升级为已读证据。
同一公告里的编程模型变化见Flash 1017 更新解读。两者虽同日发布,验证内容不同:模型能写项目,不证明研究链已读到可靠来源。
通过 Nbility 组合应用时,可先按接入基础设置已支持的模型请求;本文没有验证本站提供 DeepSeek 的独立 /v1/tools/search 与 /v1/tools/fetch。把“找到了”“读过了”“足以引用”作为三个分别检查的状态,一份简报才更容易维护和追溯。