Dify 混合检索怎样找准只差一位的产品型号
型号只差一个字符,语义相近仍可能选错产品。用 AX-17 演示资料对照全文、向量和混合检索,并在回答前核对精确型号。
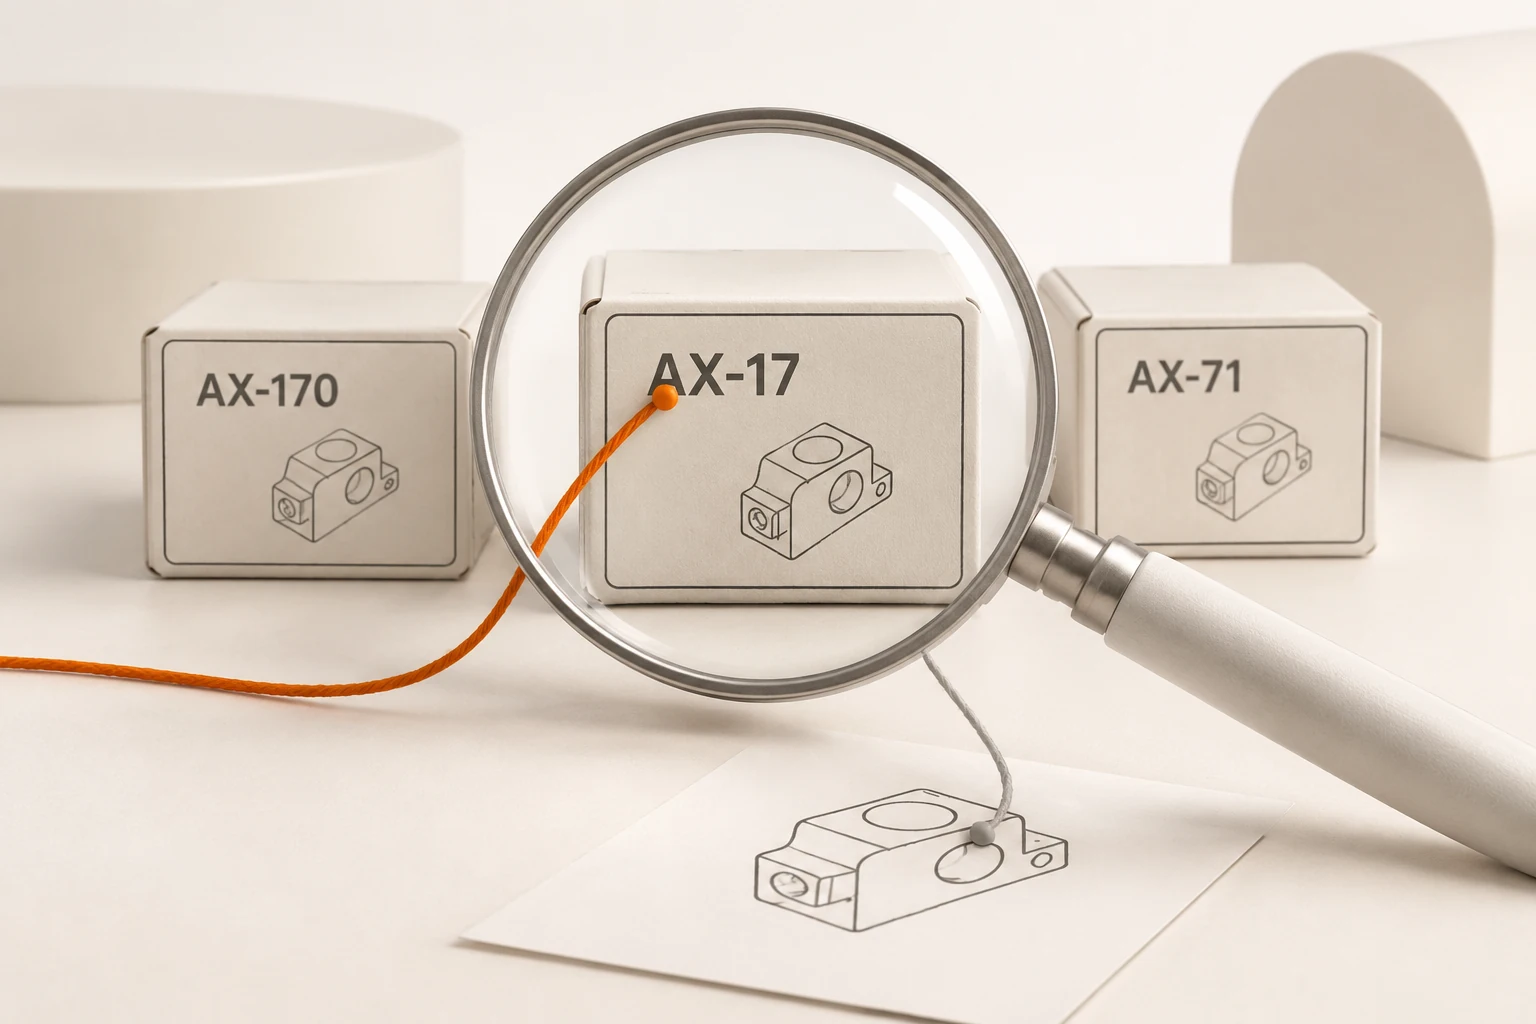
用户问 AX-17 的电源规格,知识库却找来了 AX-170 的说明书。两份资料讲的东西很像,回答也可能顺畅,但型号一旦选错,后面的参数都不能直接用。Dify 混合检索可以同时利用字词和语义线索;产品身份仍要在回答前单独核对。
为什么全文和向量检索要一起看?
向量检索按含义找相近内容,适合“那个带红灯的小设备怎么复位”这类问法。全文检索利用文本中的词,更适合追踪型号、错误码和专业名称。二者处理的线索不同;不能由“语义分数很高”推出“型号逐字一致”。
Dify 当前检索设置文档说明,高质量索引支持向量、全文和混合三种检索。混合模式可以使用语义与关键词权重,也可以配置重排模型。这里说的是高质量索引,不要把它与经济索引的关键词机制混为一谈。
全文检索也不等于数据库里的精确字段查询。分词器可能把 AX-17 拆开,大小写、连接符或中文夹英文的方式也可能影响匹配。是否完整命中型号,要看当前向量库和实际返回,不能只看开关名。
用哪些资料才能看出差别?
在临时知识库放三条明确、互不兼容的教学资料,不用真实设备做带电试验:
| 片段 ID | 正文 |
|---|---|
ax17-power | 演示设备 AX-17 使用 12V 电源,圆孔接口。 |
ax170-power | 演示设备 AX-170 使用 24V 电源,接线端子接口。 |
ax71-reset | 演示设备 AX-71 的红灯常亮时,按复位键三秒。 |
这些规格是虚构的测试输入,不是产品建议。三个型号都保留在正文中,并为每个片段记下产品标识。先检查解析与分段结果,确保 AX-17 没被清洗掉;资料本身缺字时,调检索权重没有依据。
用同一份资料问四个问题:“AX-17 用几伏”“AX-170 用几伏”“红灯常亮怎么复位”“AX-19 用几伏”。前两题检查身份,第三题检查口语语义,第四题检查没有该型号时会不会借邻近说明书作答。只测第一题,容易得到对某个权重过度乐观的判断。
怎样对照三种检索而不被聊天答案带偏?
先在 Retrieval Testing 直接查看候选片段,分别记录全文、向量、混合检索时的文档 ID、片段 ID 和排序。保持资料、问题和分段相同,先只变检索方式。混合模式再逐步调整权重,不同时更换 Embedding、重排模型和提示词。
没有适合所有资料的固定比例。型号题希望完整标识保留,口语题又需要语义召回;应该用两类问题共同选择。若正确片段根本没进候选,按候选覆盖与 Rerank 的区别回查召回,不只增加最后返回的条数。
当前知识检索节点文档还区分知识库层和节点层设置;搜索多个库时,节点会合并各库结果后再处理。测试页调过的设置仅对当前测试会话生效,正式应用要另核对选中的库、节点与发布版本。
能不能让型号不匹配时停下来?
可以在自己的应用里为已明确给出的型号加一道精确核对。以下程序只处理一个独立型号输入,不负责从自然语言提问抽取型号,也不是 Dify 的分词器:
import unicodedata

catalog = {
    "AX-17": {"chunk_id": "ax17-power", "volts": 12},
    "AX-170": {"chunk_id": "ax170-power", "volts": 24},
}
user_code = "AX-17"
code = unicodedata.normalize("NFKC", user_code).strip().upper()
match = catalog.get(code)
if match is None:
    print("No exact product; ask for the model label.")
else:
    print(code, match["chunk_id"], match["volts"])
NFKC 在此把全角字母数字转成半角;没有删连接符、纠正拼写或把相近型号合并。别名应来自自己维护的产品表;遇到 AX-19,让用户检查铭牌,比拿 AX-17 的参数顶上去更合适。自然语言里出现多个型号时,还要先澄清是在对比还是只问其中一个。
上线前分别验收“候选含目标型号”“给模型的上下文仍是该型号”“最终参数有对应出处”。只有检索命中还不够;最终回答不要把另一份手册的数字拼进来。条件和例外被切开时,继续查父子分段怎样带回上下文。
本文于 2026 年 11 月 21 日核对官方文档和 Dify 1.20.0 发布记录。发布记录列出了 Weaviate 关键词/混合结果的 BM25 分数修复;这只支持检查该后端与版本,不说明所有召回错误都已修好。我们只离线验证了上面的型号规范化与精确查找,没有运行 Dify 或测量混合检索准确率。通过 Nbility 配置模型时,可先核对 Embeddings 接口;分词、索引和产品身份校验仍在知识库与应用这一侧完成。