Gemini Argon 的百万 Token,要给读、想和写一起留位置
读懂 Gemini 4 Argon 的统一上下文与长输出:输入、思考和答案共享容量,超过 64K 需要后台执行,还要收齐多段结果并检查完成状态。
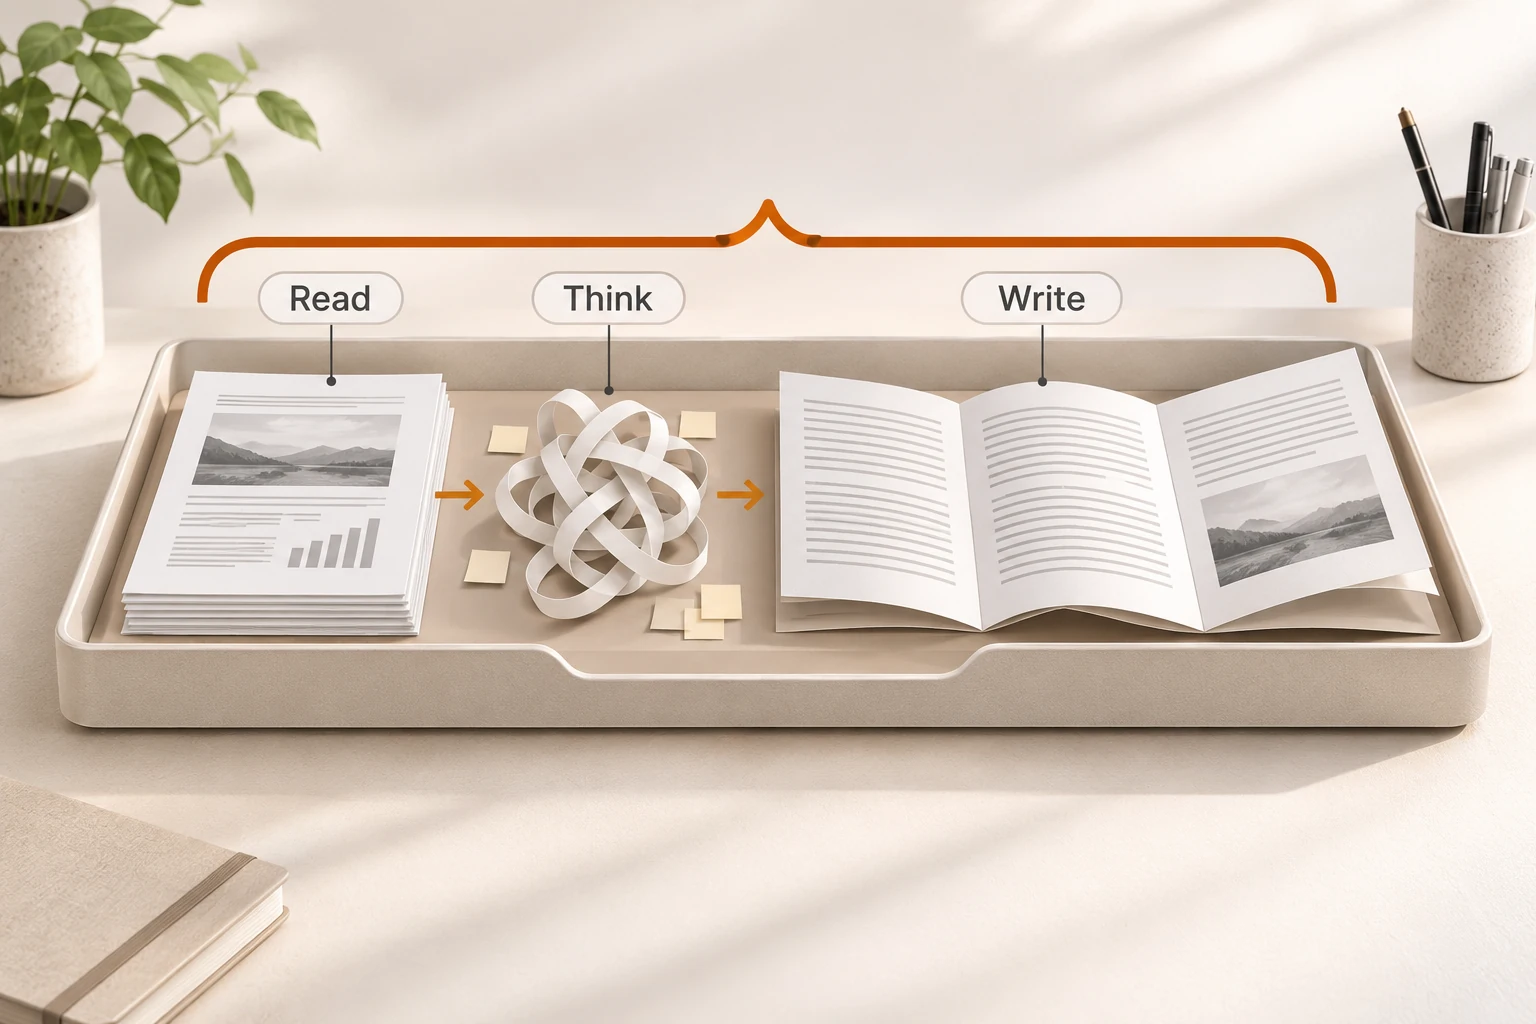
把一整套资料交给模型,再让它写完整报告,容易同时碰到两个限制:资料装不装得下,答案能不能写完。Gemini 4 Argon 把两者放进了同一个窗口,输入、思考和输出共享 1,048,576 Token。看到“百万上下文”和“百万输出”,不能把它们相加。
Google 在 2026 年 10 月 13 日宣布 gemini-4-argon 正式可用。本文于 11 月 11 日重读发布记录、Argon 指南与长输出文档,解释它适合怎样的长任务。本文没有运行百万 Token 请求,也没有测量记忆准确率或生成速度。
一个窗口,三份开销
过去只看“输入上限”的习惯,在这里不够用。工具声明、对话历史和多模态材料会占输入空间,模型的思考也要占位置,最后才是读者拿到的答案。
假设输入已经占去 700,000 Token,那么窗口里至多剩下 348,576 Token,供后续思考与输出共同使用。这只是容量减法示例,不是实际调用记录;真实请求还要把工具和其他上下文计入。不能因为正文预计只写 100,000 Token,就把其余位置全部塞满。
max_output_tokens 还会对思考加输出施加另一道上限。思考先用掉很多额度时,留给答案的部分就会变少。thinking_level 支持 low、medium、high,默认 medium;提高档位不是增加窗口大小。遇到截断,应先检查状态与额度,再决定减少材料、调整思考档位还是拆任务。通用计算思路见上下文超限说明。
超过 64K,需要换一种执行方式
官方文档区分了两条路径:
| 路径 | 输出方式 | 应检查什么 |
|---|---|---|
| 普通同步请求 | 默认至多 65,536 Token | 思考和答案是否一起碰到上限 |
| 后台长输出 | background: true,并显式设置大于 65,536 的 max_output_tokens | 保存交互 ID、查询状态、收集全部输出段 |
只打开 background、不设置更大的输出额度,仍会在 64K 停止。后台模式也不能突破统一窗口扣除输入后的剩余空间。官方还提供客户端续写路径,适合需要自行控制重连、重试或不保存交互的应用;它不是把同一个同步请求无限等下去。
后台长输出会由服务端按 64K 的续写段推进,每段增加一个 model_output step。客户端若只显示最后一段,可能把一份完整结果误看成缺了开头;若只取第一段,又会漏掉后续。
下面是离线结果读取示例,字段来自当天官方文档;它不创建请求,也不表示真实服务已验证。把一次查询得到的 JSON 保存为 interaction.json 后,可用它检查状态并合并文字:
import json
from pathlib import Path

interaction = json.loads(Path("interaction.json").read_text())
if interaction.get("status") != "completed":
    raise SystemExit(f"Not complete: {interaction.get('status')}")

parts = [
    item["text"]
    for step in interaction.get("steps", [])
    if step.get("type") == "model_output"
    for item in step.get("content", [])
    if item.get("type") == "text"
]
if not parts:
    raise SystemExit("No text output")
Path("answer.txt").write_text("".join(parts), encoding="utf-8")
请求被中断时,先用已有交互 ID 查询状态;没有确认任务结果之前,不应把新的 POST 当作“继续等待”。客户端是否支持这套交互与续写协议,还要另查。本站的三种 API 格式说明可帮助分清原生接口与兼容层。
长输出值得用在有结构的交付上
比较适合尝试的任务,是材料之间需要反复对应、结果又必须保持整体结构的工作。例如,把一组公开接口说明整理成迁移手册:每章对应一个接口,列出旧字段、替代方式、来源和未解决问题。长输出可以减少人为拼接章节的次数,却不能代替逐项核对。
先给一份小材料写出交付约定:
根据提供的三个公开接口文档,整理迁移手册。
每个接口单独成章,包含变更、调用方影响、检查步骤与原文链接。
资料没有说明的行为写“未说明”,不自行补全。
正文最后列出所有接口,标记哪些已写完、哪些仍缺证据。
扩展到更大的材料集时,保留接口目录和来源表。验收要检查章节是否齐全、前后定义是否一致、引用能否支持结论,以及代码片段有没有实际通过相应检查。大窗口说明容量,不能证明每条材料都被正确使用。PDF 引用链的检查方法同样适用于长报告。
若任务能自然拆成彼此独立的短报告,未必需要一次写到很长。先比较完整交付的等待、返工与结果,再决定是否合并;不要把输出字数当成质量指标。
接入前还有两处容易沿用旧设置
Argon 当前仅支持隐式上下文缓存,不支持旧式显式 cached_content。迁移时需要检查创建缓存和引用缓存的代码,不能直接搬过旧模型配置。官方指南还说明 temperature、top_p、top_k 目前会被忽略,应移除这些设置,避免应用给人一种仍能控制采样的错觉。
另一个边界是能力与协议。模型页列出文本、图片、视频、音频和 PDF 输入,输出为文本;接受音频输入不代表能输出语音,支持长输出也不代表所有客户端都实现后台续写。
通过 Nbility 选择模型时,先按模型 ID 文档确认当前令牌可用目录,再核对所需协议。Google 的原生 Interactions 功能不会因为模型名字出现在兼容列表里就自动可用。先用小材料收齐一份结果,再把任务放大,才能判断更长的窗口是否真的帮到了交付。