用 Gemini Embedding 2 搜素材,先决定一条向量代表什么
Gemini Embedding 2 可跨文字、图片、音视频和 PDF 检索;按素材片段建记录,分清输入聚合与独立向量,才能把命中带回原文件。
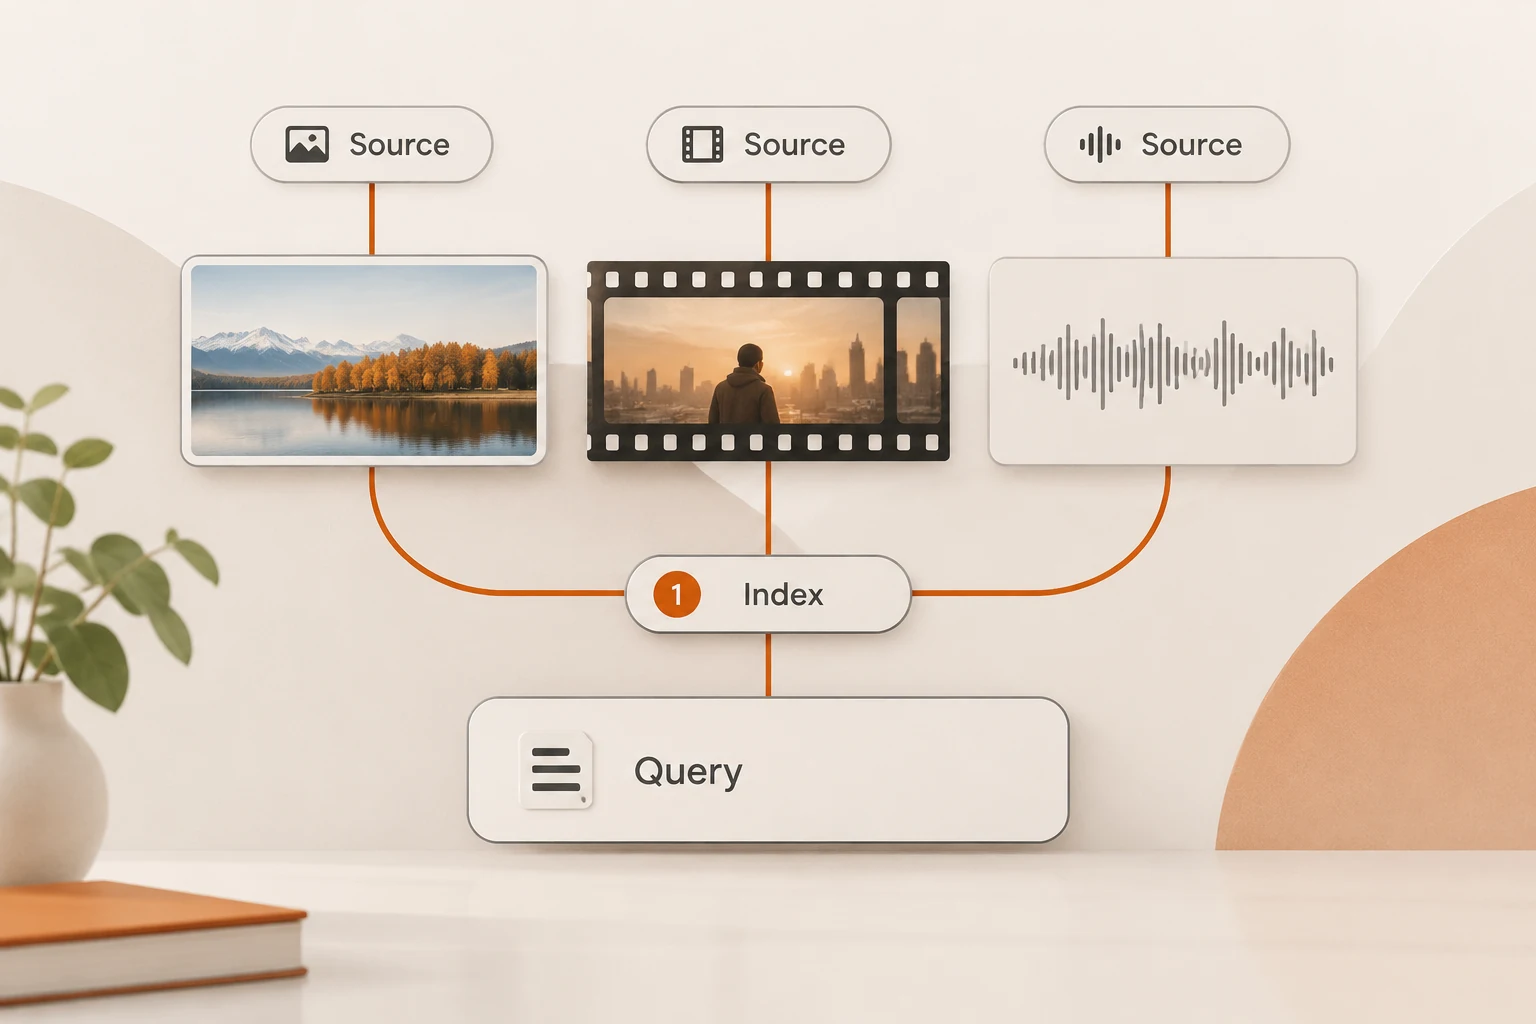
Gemini Embedding 2 可以把文字、图片、音频、视频和 PDF 映射到同一个向量空间,用一句话检索不同类型的素材。真正影响素材库能否用起来的,是每条向量代表什么,以及命中后能否回到原文件的具体位置。把整批文件混成一个向量,会让搜索结果难以定位。
本文于 2026 年 11 月 18 日重读Embedding 指南和模型页。模型页标记最近更新为 2026 年 4 月;11 月 6 日是 preview 弃用与路由调整,不能把它写成今天刚发布的模型。下面给出素材检索的设计与验证方法,未调用模型或测量检索效果。
多模态检索适合找什么?
适合从混合素材里找“与描述有关的东西”:例如寻找讲到包装开封的短片、包含红色背包的照片,或讨论售后问题的录音片段。查询和素材不必都是文字。
但相似度只负责排候选,不能证明图片里一定有某件商品,也不能替代录音逐字稿。检索命中后还应打开原文件,用视觉、转写或人工核对确认。若任务要求精确金额、日期或合同条款,关键词、结构化筛选与原文定位仍然有用。
这一层与Rerank 的候选覆盖问题相接:后面的排序或回答模型,只能处理实际交给它的候选。不要用“统一空间”推导所有内容都能被可靠找回。
一条向量应该代表整件素材还是其中一段?
先按读者需要返回的单位切分。照片可以一张一条;录音按有明确起止的片段;长视频按镜头或主题段;PDF 按适合定位的页组。每条记录同时保存原文件 ID、来源位置和预处理方式。
当前官方限制需要一起考虑,不能只看模型输入 token 数:
| 模态 | 当前文档限制或处理方式 |
|---|---|
| 整体输入 | 最多 8,192 tokens |
| 图片 | 最多 6 张,PNG 或 JPEG |
| 音频 | 最长 180 秒,MP3 或 WAV |
| 视频 | 最长 120 秒;最多取 32 帧,视频音轨不处理 |
| 单次最多 1 个文件、6 页 |
视频在不超过 32 秒时按每秒一帧采样,更长时均匀采样到 32 帧。若关键动作只出现一瞬,向量未必包含它;若要搜视频里说了什么,需要另行提取音轨或转写。音频与视频两行的时长限制,也不能互换。
为什么一组输入可能只返回一条向量?
Embedding 2 会聚合放在一起的多个输入。官方将“多个 parts 合成一条表示”与“多个 Content 对象分别返回表示”区分开。输入数组长度不能直接当输出向量数量。
例如,一张商品图加一句该商品的描述,合成一条向量可能符合需求;十件无关商品放进同一个 Content,合成后就无法分别作为十个搜索结果返回。
建议先明确记录粒度,再选择输入结构。每次入库核对输出条数与记录 ID 的对应关系;不要用 zip 把少量输出静默配给一大批输入。要一次处理许多独立条目,还可以查官方 Batch API 的 embedding 支持。
纯文本检索也有一处迁移差异:Embedding 2 不使用旧模型的 task_type 字段,官方建议把任务写成文本前缀。例如查询写成 task: search result | query: 红色背包,文档写成 title: 产品图 | text: ...。混合文字与媒体聚合时,官方通常不建议直接给文字部分套任务前缀,不要照搬纯文本模板。
怎样记录索引,才能发现混用?
一条素材记录可以保留下面这些字段。它是应用侧元数据示意,不是 Google API 请求:
{
  "asset_id": "public-demo-clip-01",
  "source": "demo.mp4",
  "start_ms": 0,
  "end_ms": 20000,
  "embedding_model": "gemini-embedding-2",
  "dimensions": 768,
  "input_policy": "video-visual-only",
  "content_revision": "demo-v1"
}
模型默认输出 3072 维,官方推荐 768、1536 或 3072 维;Embedding 2 会自动归一化非默认维度。记录维度与生成策略,查询时保持一致。维数相同并不证明不同模型的向量可以互相比较,换模型还要确认向量空间;已有维度错误可读Dify 索引与缓存排查。
这次 gemini-embedding-2-preview 转正式版是官方明确说明保持同一 embedding space 的特例,不需要重建向量;具体路由日期见模型迁移记录。不要把这条保证泛化给其他模型迁移。
怎样知道“搜得到”不是只碰巧命中?
准备少量公开素材,并在跑检索前写出每个查询应当返回哪些文件、哪些只是相似干扰项。让视觉、音频内容、文字内容各有独立问题;给无关素材留一条“应当找不到”的查询。
逐条看候选里有没有正确素材,命中的时间段或页组是否准确,以及遗漏发生在哪一步。不直接沿用文字检索的相似度阈值;先观察这些固定样本,再决定是否需要按模态或任务分别设置阈值。本文没有运行这些样本,因此不报告准确率或最佳阈值。
最后把返回记录接到原文件浏览位置,PDF 保留页码,音视频保留起止时间。需要从检索进一步生成带出处的回答时,可沿用PDF 引用链的检查方法。本站的通用 Embeddings 文档描述文本接口,不代表支持 Google 原生多模态 embedContent;接入前要另核模型、端点和文件类型。