Gemini 工具太多时,可以先找再加载
Gemini Tool retrieval 可在 Interactions API 按需加载工具 Schema。服务端检索仍须每轮传完整 tools,无状态续接还要保留搜索步骤和签名。
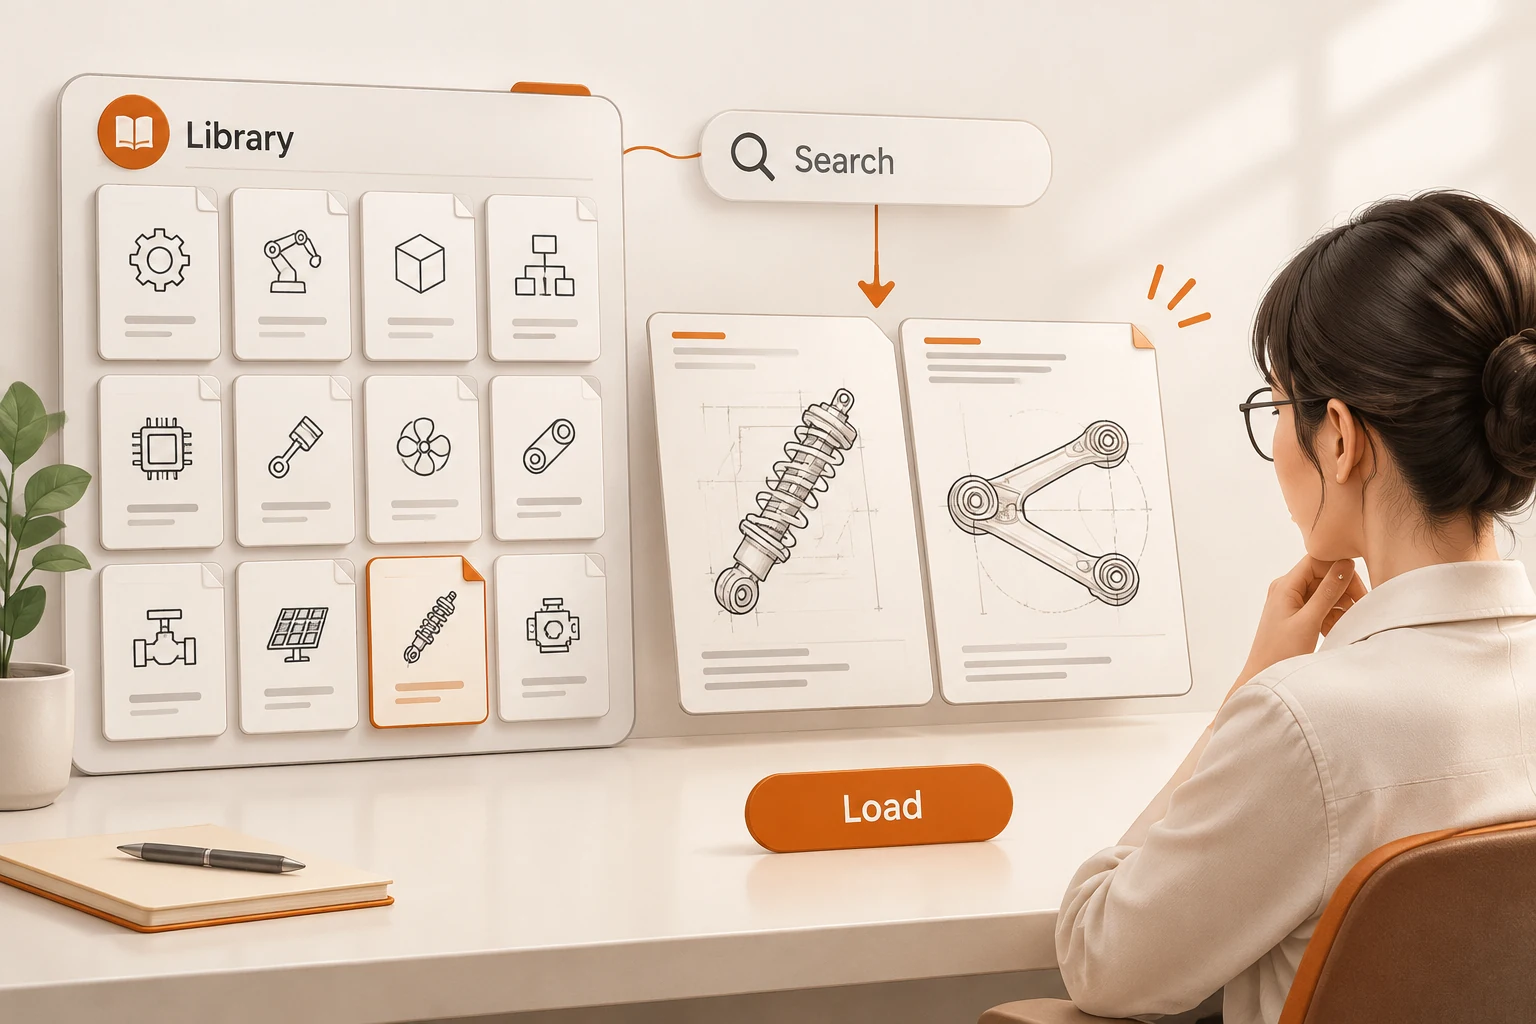
给 Agent 接入几十个工具后,可以让 Gemini 先找到相关工具,再读取完整参数定义。2026 年 11 月 19 日推出的 Tool retrieval 提供了这条路径,但当前只支持 Interactions API 的 v1beta 预览接口,不能把 defer_loading 直接加进原来的 generateContent 请求就算完成迁移。
本文于 11 月 22 日重读发布记录与完整工具检索指南。以下给出请求示例和验收方法,没有运行真实模型、MCP 服务或测量省下的 Token。
延迟加载省掉了哪一部分?
延迟加载把不常用工具的完整参数 Schema 暂时留在初始模型上下文之外;服务端模式仍需要应用提交完整工具声明。
这两个层次很容易混淆。应用发给 API 的 JSON 仍含 parameters,API 再决定何时把这份定义交给模型。不要为了缩短网络请求而删掉参数:检索成功后,模型仍需要知道怎么调用。名称、描述或 short_description 还承担“让模型找得到”的作用。
经常调用的核心工具可以保持直接加载,长尾工具再设 defer_loading: true。官方也提醒,系统指令或工具结果中直接点名的工具不要延迟加载,否则模型可能绕过搜索,直接尝试调用。
服务端检索怎么接入?
服务端检索在 tools 加入 {"type":"tool_search"},并给需要延迟的函数设置 defer_loading: true。
下面使用官方端点与指南中的 gemini-4-hydrogen。示例只查公开演示目录,不执行写操作;需要本地官方 GEMINI_API_KEY,本文只检查了 Shell 与 JSON 语法,未发送请求。
curl --silent --show-error \
  'https://generativelanguage.googleapis.com/v1beta/interactions' \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "Find the public manual for DEMO-42.",
    "tools": [
      {"type": "tool_search"},
      {
        "type": "function",
        "name": "catalog_find_manual",
        "description": "Find the public product manual by exact product code.",
        "short_description": "Catalog: find a public manual.",
        "defer_loading": true,
        "parameters": {
          "type": "object",
          "properties": {"product_code": {"type": "string"}},
          "required": ["product_code"]
        }
      }
    ]
  }' -o interaction.json
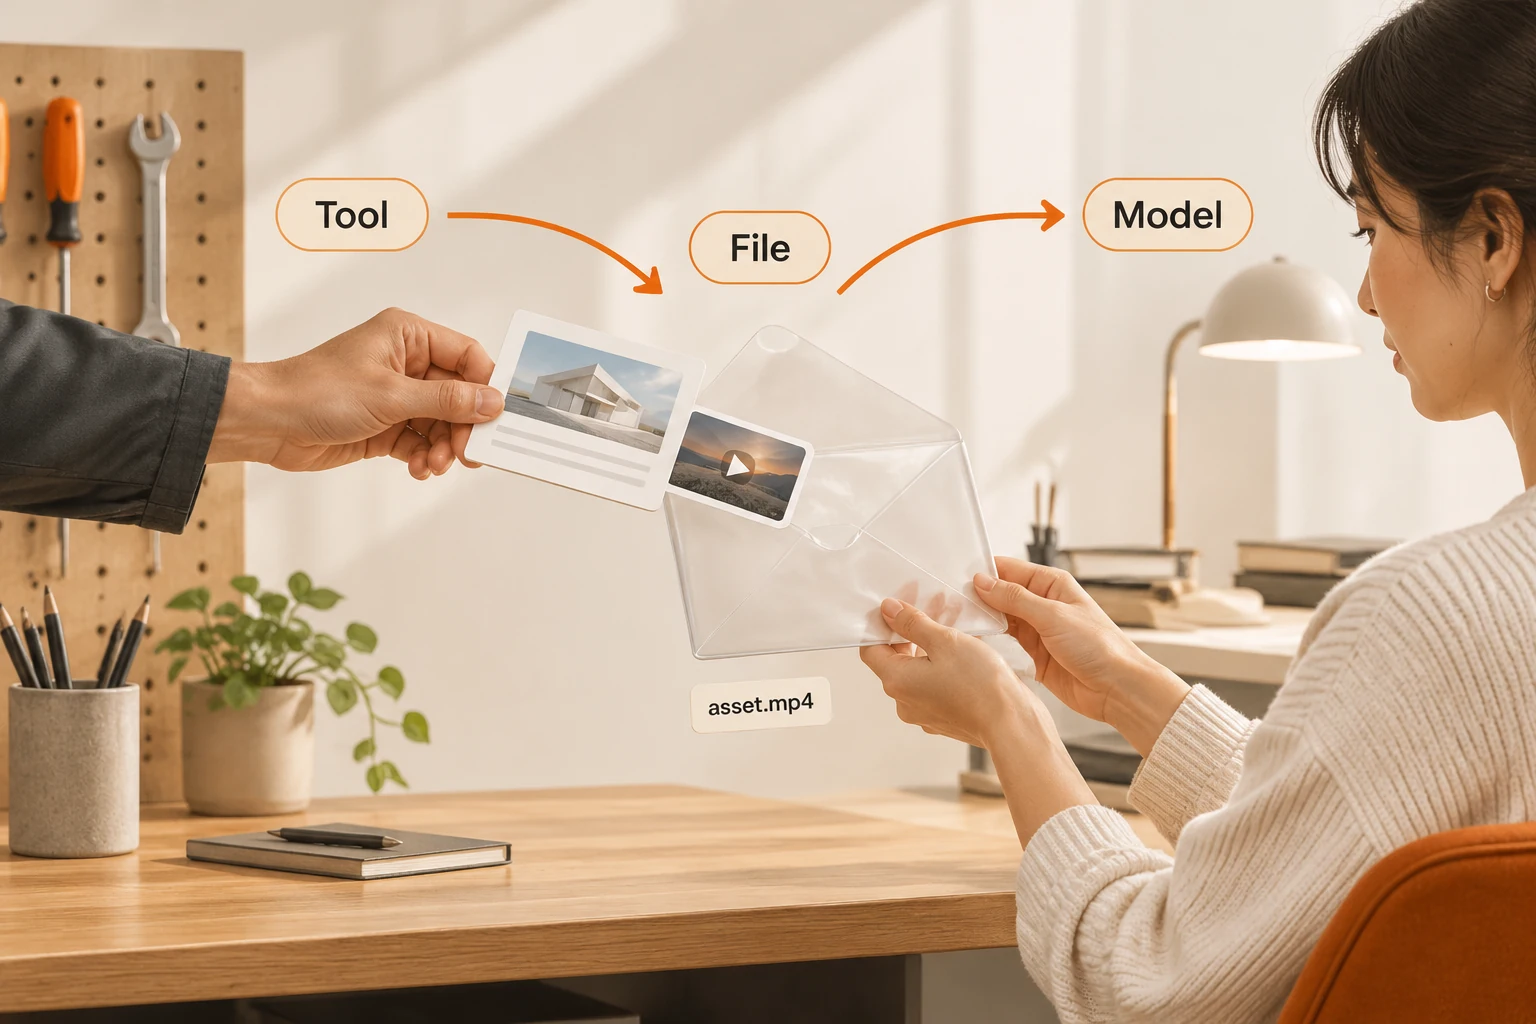
成功路径可能出现 tool_search_call、tool_search_result,然后是 function_call。前两个由服务端处理,应用负责执行最后那个函数,并把结果按 call_id 交回。每次都检查 steps 中是否有 function_call,不要只依赖 status == "requires_action"。
只有一个工具的例子是为了看清协议,并不证明这时值得启用检索。真正的取舍应比较自己的完整工具集、调用次数、错误和任务完成情况,而非引用一个通用省钱比例。
工具目录在自己系统里,能自己搜索吗?
客户端检索允许应用收到搜索请求后,返回匹配的函数声明,适合动态目录、按用户变化的工具集合和自有检索规则。
| 模式 | 工具在哪里声明 | 谁执行搜索 | 要注意什么 |
|---|---|---|---|
| 直接加载 | 初始 tools | 无额外搜索 | 适合小而稳定的工具集 |
| 服务端检索 | 初始 tools,完整 Schema | API 内部 | 每轮重传工具声明 |
| 客户端检索 | 搜索结果返回函数声明 | 应用 | 多一次搜索往返;先过滤权限 |
客户端模式的搜索工具使用 execution: "client";它与服务端检索不能混在同一个请求里,defer_loading 也只适用于服务端模式。返回的匹配项应是函数声明对象,不是 JSON 字符串。
无论哪种模式,检索都不替代权限控制。用户能搜到某个工具名,不应因此获得读取另一个客户数据的权限。服务端执行函数时仍要按当前用户检查允许的资源;工具输出与权限解释了读取到文字与获得执行授权之间的边界。
第二轮为什么还要传 tools?
previous_interaction_id 保存此前步骤,不保存工具声明。包括交回 function_result 的请求在内,每轮都要重新传完整的 tools。
若自己管理无状态历史,还要按原顺序回传模型生成的所有步骤,保留 tool_search_call、tool_search_result 和对应的 signature。缺少搜索调用或剥掉签名可能返回 400;丢掉搜索结果则可能不报错,却让已加载 Schema 从上下文消失。把历史压成纯文本会破坏这些结构。
这也是为什么模型能聊天与整条 Agent 兼容要分开验收。SDK 或网关需要识别新步骤,不能只保留最终文本和普通函数名。
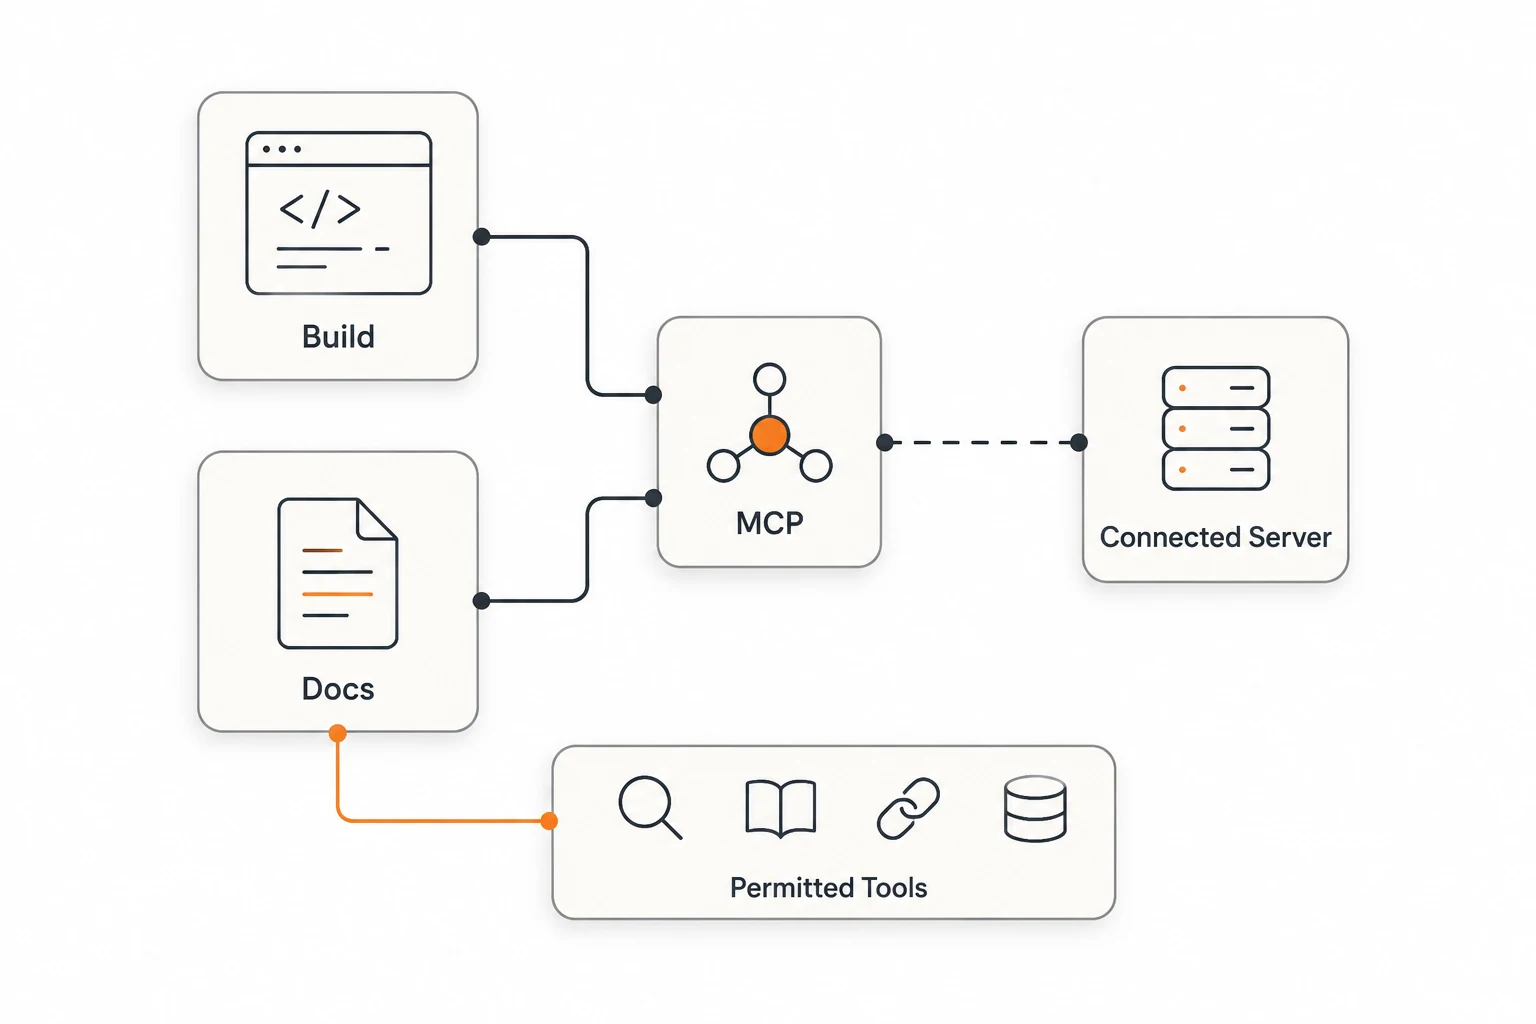
远程 MCP 也能设 defer_loading: true,但检索后 API 会在远程服务执行工具,返回 mcp_server_tool_call 与结果;这与本地函数由应用执行不同。先读清MCP 的参与方,再决定服务端应该连接到哪里。
上线前至少试哪几条路径?
先用公开、只读工具验证首次检索、结果续接、无匹配和权限拒绝,再增加真实工具。
- 提问只需要一个工具,检查它是否被发现、参数是否完整。
- 交回工具结果,检查第二轮仍带
tools,回答确实使用结果。 - 问目录没有的能力,确认没有执行不存在的工具。
- 若使用无状态历史,完整保留步骤与签名;故意删字段只在临时测试中验证错误处理。
- 用两个测试用户检查目录过滤与函数端的资源权限,不能只看检索命中。
加载后的工具目前会留在该会话上下文,不能再卸载。长会话越用越多时,仍需要上下文管理。本站Gemini 原生兼容文档目前说明的是生成与流式生成路径;本文不把它写成已经验证 Interactions 工具检索。打算经网关使用时,应先确认接口与事件覆盖,再迁移真实任务。