Hermes 240 秒超时:SSE 还有保活,为什么仍会断开重试?
针对 Hermes 的 Stream stale 日志,区分连接保活、数据块停顿和整条流的等待时间,核对 v0.23.0 的模型级配置,并用原始 SSE 排查重复重试。
Hermes 普通聊天能用,换成长上下文任务后却每隔几分钟断开,日志写着 Stream stale for 240s。与此同时,代理还在发送 SSE 保活。遇到这种情况,先确认 Hermes 等待的是什么信号,再决定改哪个超时。
保活说明这段连接仍有数据经过;模型正文、推理增量或工具参数有没有继续返回,需要另外判断。把全部超时一起调大,会让真正卡死的请求也等得更久。
本文于 2026 年 11 月 8 日核对 Hermes 最新正式版 v0.23.0 的文档与源码。下面的故障线索来自当天的社区报告;本文没有独立复现完整 Hermes 的 240 秒故障,也没有验证某个线上服务必然触发它。初次接入请先完成 Hermes 的 Nbility 配置,本文处理接通以后的长请求问题。
当天的报告说明了什么
Hermes Issue #151280 的作者使用 v0.23.0,通过一个 OpenAI 兼容代理运行长思考任务。作者报告:代理持续发送 SSE 注释保活,Hermes 仍在 240 秒附近取消连接并重试。日志摘录中同时出现:
Stream stale for 240s (threshold 240s) — no chunks received.
http_status=200 bytes=40 chunks=1 ... finish_reason_seen=False
截至本文查阅时,Issue 仍为 Open,有两条社区回复,均不能当作维护者确认或正式修复公告。其中一条回复也特别说明:自己的历史日志能证明超时发生,不能证明那些连接当时都在收到保活。
能够直接核实的是:v0.23.0 的官方配置文档明确写到,stale 检测会终止“收到 SSE 保活、却没有实际内容”的流。对应源码用最后收到的解析后数据块更新时间,取消函数的注释也写明了处理 ping-only 连接的意图。
所以,诊断重点是“这个等待策略是否适合当前请求”。仅凭这条日志,还不能判定代理断网、模型停止生成,或某一方存在普遍故障。
: keepalive 和模型数据走的是两条判断路径
下面是协议示意,不是线上抓包:
: keepalive

data: {"choices":[{"delta":{"role":"assistant"},"finish_reason":null}]}

: keepalive

data: {"choices":[{"delta":{"content":"OK"},"finish_reason":null}]}

data: {"choices":[{"delta":{},"finish_reason":"stop"}]}

data: [DONE]
按 WHATWG 的 SSE 解析规则,以冒号开头的行是注释,解析时忽略。它可以保持传输活跃,却不会作为普通 data: 事件交给应用。
Hermes 的流式停顿检测则观察解析后的数据块。这里也不能把“收到数据块”直接读成“用户看到了文字”:仅含 role 的块可能被计入,正文仍然为空。反过来,底层收到了许多注释,应用层也可能一直没有新块。
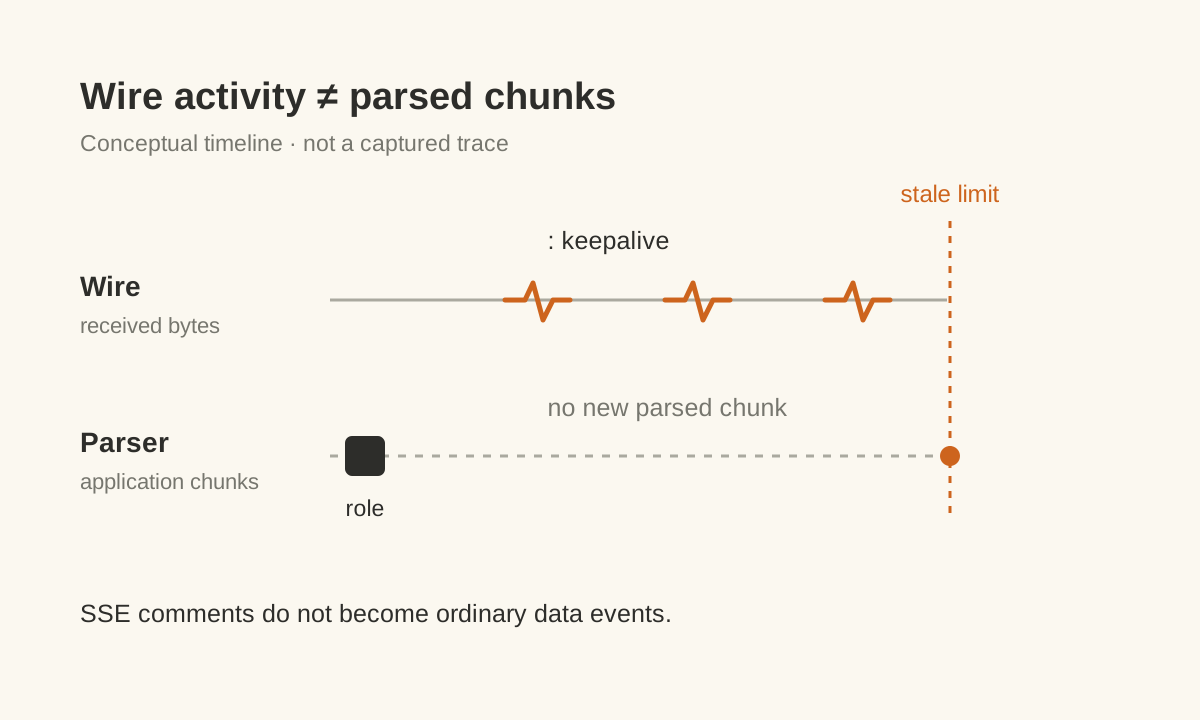
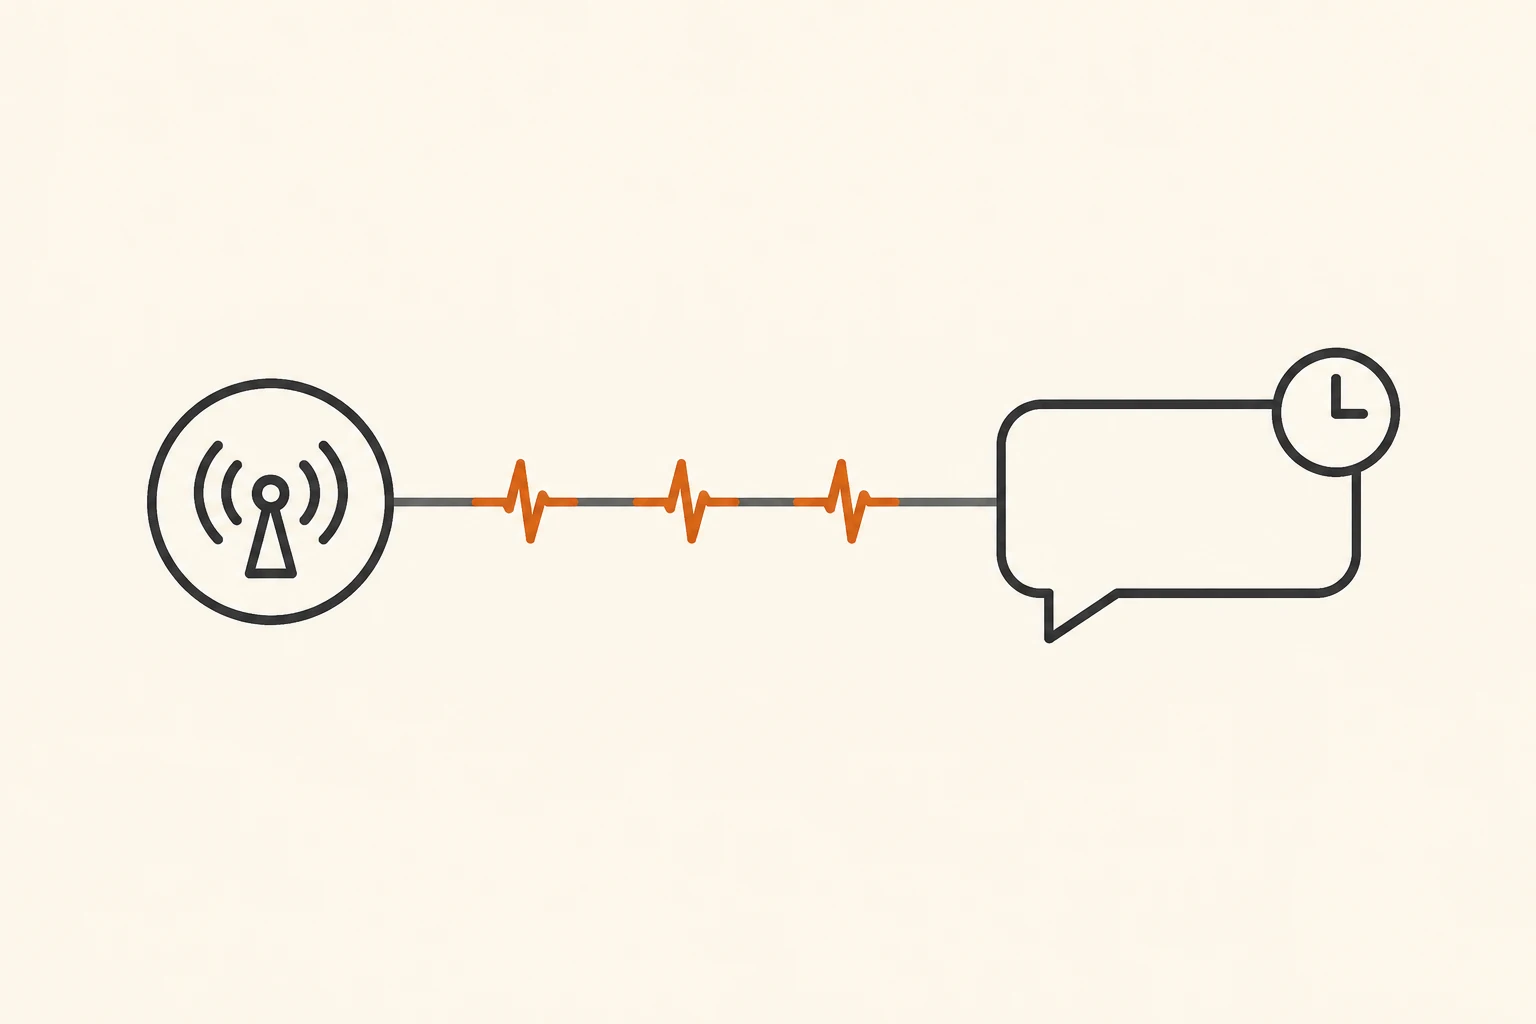
图为机制示意,没有使用真实时延数据。排查时同时记录最后收到字节、最后收到数据块、最后出现正文或推理增量的时间,才能区分“连接活着”和“生成有进展”。保活本身也不能证明代理后面的模型仍在工作。
先看谁结束了请求,再看等待了多久
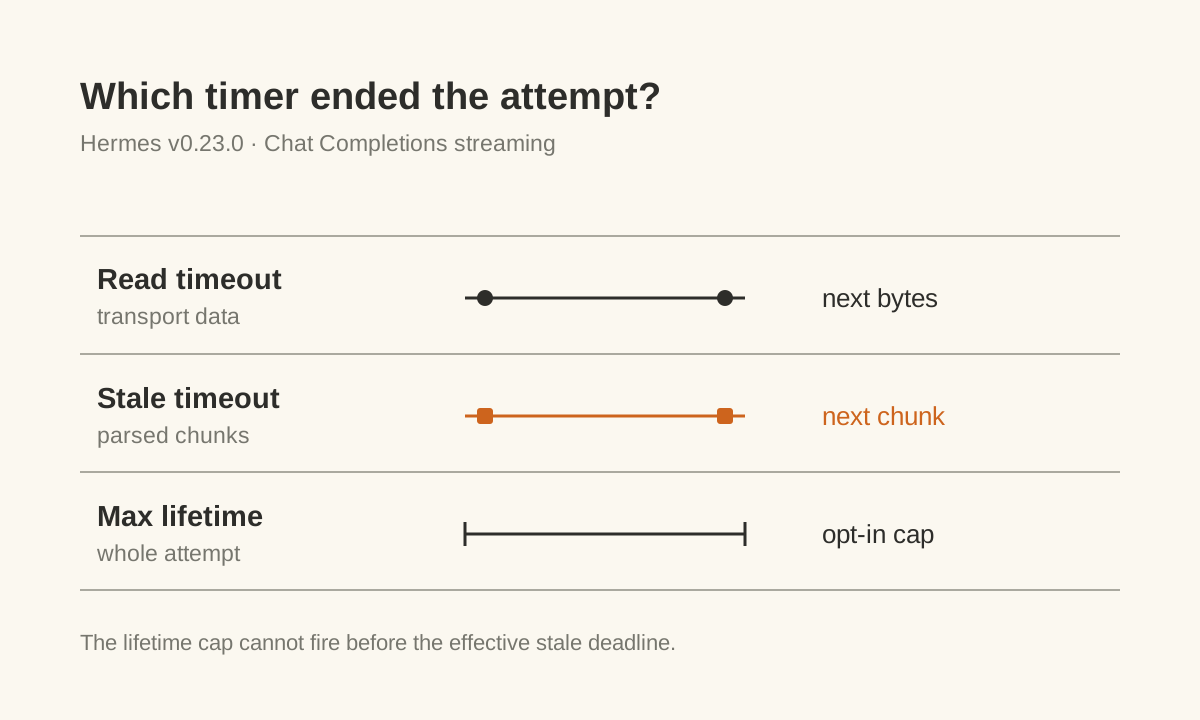
对本文的 Chat Completions 流式路径,先分清这三个限制:
| 限制 | 等待什么 | v0.23.0 中相关的设置 | 容易误解的地方 |
|---|---|---|---|
| Socket read timeout | 下一批传输数据 | HERMES_STREAM_READ_TIMEOUT | 增大它,不一定延长 stale 检测的耐心 |
| Stale stream timeout | 下一份解析后数据块 | providers.<id>.models.<model>.stale_timeout_seconds | 保活注释不会按普通数据块刷新计时 |
| Stream max lifetime | 一次流式响应的总时长 | agent.stream_max_lifetime | 默认关闭;启用后也不会早于有效 stale 阈值触发 |
官方文档还限定了 stream_max_lifetime 的适用范围:Chat Completions 和 Anthropic Messages 流;它不覆盖 Codex/Responses 或 Bedrock 流。不要把这个表直接套到另一条传输路径。
240 秒不是所有 Hermes 请求的固定超时。 在没有显式配置时,云端流式 stale 基础值为 180 秒,估算上下文超过 50k、100k 时分别至少提高到 240、300 秒;部分推理模型还有额外下限,隐式值也可能受到运行预算约束。以当前请求日志中的 threshold 为准。
先找结束前的第一条错误:是 Hermes 的 Stream stale,还是读取超时、服务端错误或外层代理断开?如果出现 401、404、429、502 等,应先按 API 状态码排查顺序处理,不把不同故障都归到这个 240 秒案例。
用原始 SSE 缩小范围,别只看 HTTP 200
先选一个公开、短小的提示词,排除工具和私有代码。下面在 Bash 中运行,假定已经通过私密方式设置 NBILITY_API_KEY;模型 ID 替换为当前令牌可用的真实值。接口字段见 Chat Completions 文档。
: "${NBILITY_API_KEY:?Set NBILITY_API_KEY before running}"

curl -N -sS --connect-timeout 10 --max-time 60 \
  https://api.nbility.ai/v1/chat/completions \
  -H "Authorization: Bearer $NBILITY_API_KEY" \
  -H 'Content-Type: application/json' \
  --data-binary '{
    "model": "YOUR_MODEL_ID",
    "messages": [{"role": "user", "content": "Reply with OK."}],
    "stream": true
  }'
-N 关闭 curl 自身的输出缓冲;此命令不自动重试。60 秒是本次探测主动设置的总时限,不能用它复现 240 秒 watchdog。若出现 curl 的超时退出,只说明探测到了自己的时限;上游是否还在执行,要另查记录。
短请求返回正常后,再用经过脱敏的长请求逐项加回上下文和参数。核对 Hermes 实际使用的 provider、精确模型 ID、协议与参数,否则只是验证了另一条更简单的路径。
观察顺序是:
- 收到的是错误 JSON,还是 SSE?HTTP 200 本身不证明生成完成。
- 有没有连续的
: keepalive注释?有注释只证明当前这段链路有数据。 data:中是什么:角色、正文、推理增量、工具参数,还是只有空对象?- 正常结束标记有没有到达?连接结束和生成正常结束需要分别看。
不要把 bytes=40 chunks=1 当作完整网络流量统计。v0.23.0 这条诊断路径的 bytes 来自对解析后块的大小估计,不能据此断言“整个连接只收到 40 字节”。也不要为了排错开启会打印认证头的完整 trace;向外提供记录前,去掉 Key、业务内容和账号信息。
确认是 stale 后,只调整出问题的模型
如果原始流和上游记录支持“请求确实在处理,只是返回数据块的间隔超过当前阈值”,可以给该模型更长、但有限的等待时间。使用 hermes config edit,在当前 profile 的配置里合并下面的片段,保留已有的地址、认证和其他模型设置:
providers:
  YOUR_PROVIDER_ID:
    models:
      "YOUR_MODEL_ID":
        stale_timeout_seconds: 600
YOUR_PROVIDER_ID 必须匹配 Hermes 运行时选中的 provider;YOUR_MODEL_ID 是精确模型 ID,可以包含 /。不要只按服务商显示名新建一段配置,再假定它会作用于现有连接。
600 秒只是演示值。 根据可核对的实际等待间隔和可接受的任务时长选择值;调大意味着遇到真卡死时也会更晚失败。模型级值优先于 provider 级值,显式配置会直接作为流式 stale 阈值使用,不再自动叠加上下文档位和推理模型下限。
保存后用新启动的会话做一次受控验证;由 gateway 托管的会话还要确认实际服务进程加载了当前 profile 的配置。不要为验证而重启仍有任务在运行的实例。可先读取这一项,确认写到了预期路径:
hermes config get 'providers.YOUR_PROVIDER_ID.models.YOUR_MODEL_ID.stale_timeout_seconds'
配置读取得到 600,只说明该项可读。是否命中当前模型、是否还有更外层的期限,需要从新请求的行为和日志继续确认。若仍然按旧阈值断开,先查 provider、模型、profile 和进程,再考虑继续增大数值。测试没有改善时恢复原值;原来没有这一项,就只移除新增的 stale_timeout_seconds。
报告作者还提到一个让特定代理输出推理增量的参数,那属于该代理的行为。本文没有把它写进 Nbility 配置:应先查所用服务的文档与实际返回,再决定是否添加额外字段。
验证完成,至少要看到什么
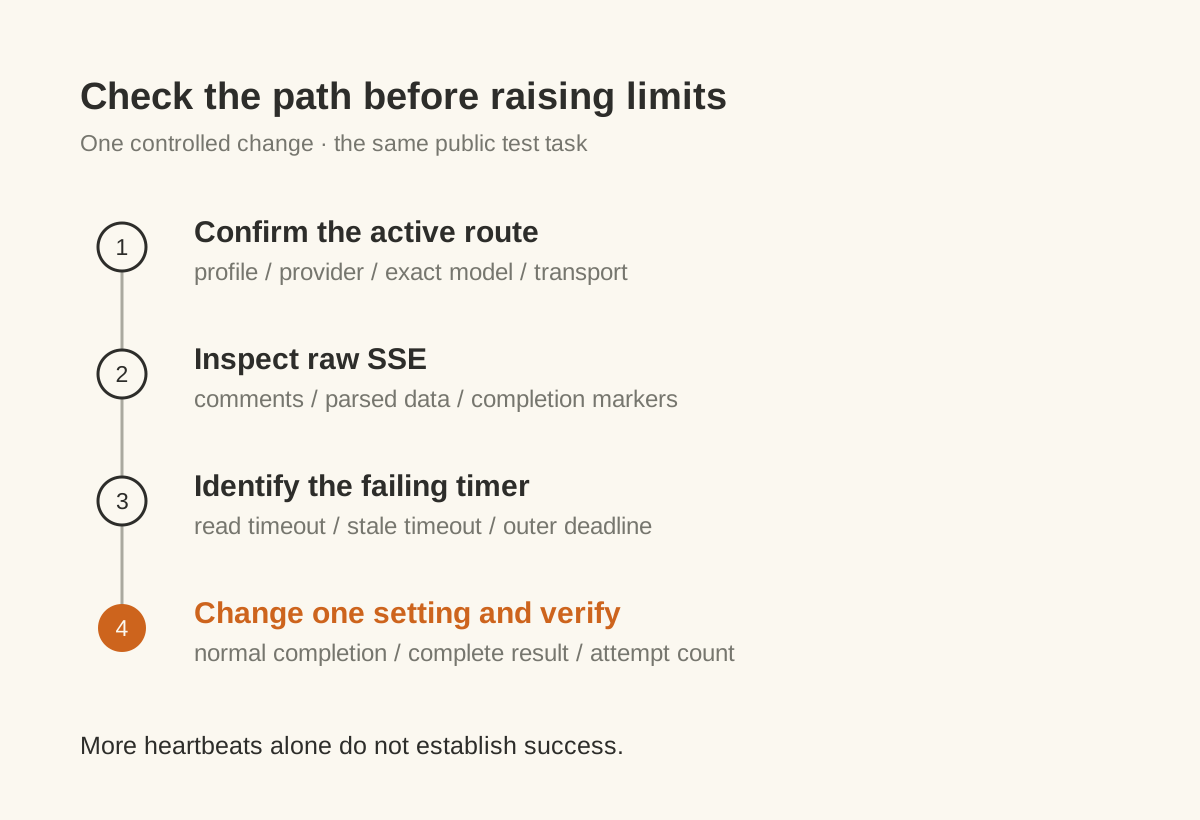
用同一份公开测试任务,记录修改前后的客户端版本、profile、provider、模型、实际阈值、结束原因和尝试次数。成功的迹象是:同一请求在允许的时间内收到有效数据并正常结束,Hermes 也完整展示结果;仅看到心跳更多、HTTP 200 或连接更久,都还不够。
如果放宽等待后仍只剩保活,没有后续数据,停止继续放大阈值,带时间线查代理缓冲和上游执行状态。若反复经历同样的超时,先检查客户端、SDK、代理与任务层是否都在重试;多层重试的放大过程解释了为什么一次失败会拖成更长等待。工具已经执行过写操作时,还要先核对副作用,避免把整个 Agent 任务重新跑一遍。
使用 Nbility 时,可以把失败时间、模型和尝试次数与用量日志对照。请求中断和用量是否已经发生是两件事;仅凭客户端超时,不能推断未生成、未产生费用或必然重复收费。需要协助时,按错误文档中的记录清单提供脱敏信息。
本文的本地验证覆盖了合成 SSE 中的注释与数据读取,以及 v0.23.0 配置解析函数对模型级设置的选择;没有运行真实上游的长思考对照,不给出节省时间或费用的比例。