用 Mistral OCR 找出扫描件里需要复核的那一块
Mistral OCR 4.1 可返回段落坐标与块级置信度,帮助定位待复核区域。平均分、最低分和类型分含义不同,高分也不能证明金额或否定词正确。
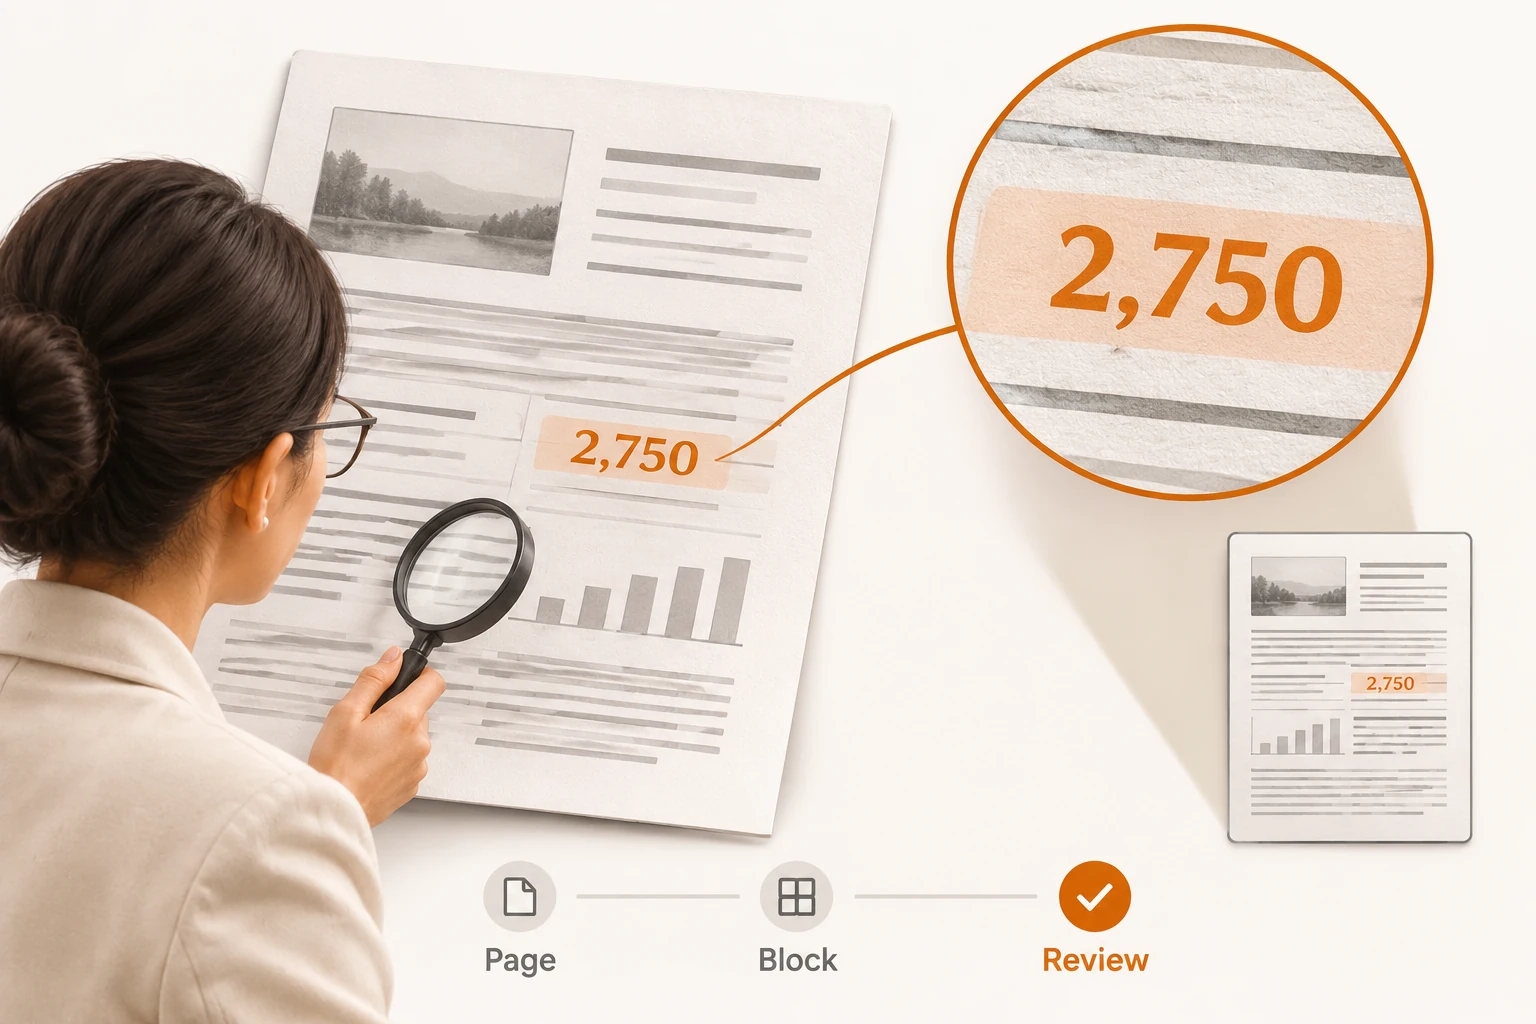
一份扫描件可能大部分识别清楚,只在金额、日期或“不得”两个字上出错。Mistral OCR 的段落块与置信度可以帮助把复核位置缩小到具体区域,但分数不能证明内容正确,更不能替代关键字段的原件核对。
截至 2026 年 11 月 22 日,官方更新记录与OCR 指南支持使用 mistral-ocr-4-1,结合 include_blocks 和 confidence_scores_granularity: "block" 取得结构与分数。块级置信度是 7 月已有的能力,本文把它作为长期文档处理问题来讲,不包装成刚发布的新功能。没有上传扫描件或测量识别准确率。
页级、块级、词级应该选哪一种?
需要安排人工复核时,块级结果便于同时保留阅读顺序、区域坐标和局部分数;只想知道整页概况可以先看页级,追查具体词再看词级。
| 取值 | 返回的主要信息 | 能帮助你做什么 |
|---|---|---|
page | 每页平均与最低内容置信度 | 找到值得展开检查的页 |
block | 页级统计;开启块提取时,各块还有分数 | 把复核任务定位到段落或表格区域 |
word | 页级统计与逐词分数,表格也有相关记录 | 查看具体词的识别疑点 |
block 不能单独代替 include_blocks: true。当前结构块提取要求 OCR 4 或更新模型;官方说明较早模型可能接受参数却返回空数组。因此空 blocks 不应自动解释成“这页没有内容”。
这与DeepSeek OCR 页完整性检查是两个不同问题:一份结果是否覆盖全部页面,和某个已经返回的字是否可靠,都应检查;两家的字段不能互抄。
怎样请求块和分数?
同一个 OCR 请求同时开启 include_blocks 与块级置信度即可。下面固定 mistral-ocr-4-1,避免后续 latest 别名变化影响比较。
curl --silent --show-error 'https://api.mistral.ai/v1/ocr' \
  -H "Authorization: Bearer $MISTRAL_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "mistral-ocr-4-1",
    "document": {
      "type": "document_url",
      "document_url": "https://arxiv.org/pdf/2201.04234"
    },
    "include_blocks": true,
    "confidence_scores_granularity": "block"
  }' -o ocr-response.json
示例沿用官方指南的公开论文 URL,需要本地官方 MISTRAL_API_KEY,本文未发起请求。实际业务应使用有权处理的文件,并确认服务可访问来源;不要把客户内网地址直接当公开 URL。
返回块包含 type、四个边界坐标与 content,按阅读顺序排列。表格块可用 table_id 关联 tables,图片块可用 image_id 关联 images。保留这些关系,后面才能从一项业务字段回到原件区域。仅把所有 content 拼接成长字符串,会丢掉定位信息;PDF 引用链讲了类似的出处保存问题。
三个块分数分别说明什么?
平均内容分、最低内容分与块类型分描述不同判断,不能合成一个笼统的“文档准确率”。
average_content_confidence_score:该块内容的平均置信度。minimum_content_confidence_score:该块内容中最低的置信度。block_type_confidence_score:被识别成某种结构类型的置信度,例如表格或标题。
一个区域很像表格,不等于表格里的小数点识别正确。平均分很高,也可能掩盖一个低分的否定词。图片等没有文字的块,其内容分可以为 null,这不是正常文字获得了零分,也不应直接自动通过。
更稳妥的工作方式是把“金额、账户、日期、否定词和例外条款”列成业务复核项,再用分数帮助排序。重要字段即使高分也要核对;低分、缺分或不认识的结果形状应进入待核路径。
能先用程序列出待复核区域吗?
可以按分数与缺失情况列出候选区域,但程序输出应叫“待复核清单”,不能叫“正确内容清单”。下面是独立的离线示例,读取保存的 OCR JSON:
import json
import math
from pathlib import Path

result = json.loads(Path("ocr-response.json").read_text())
threshold = 0.90  # Demonstration policy, not a vendor recommendation
review = []
for page in result["pages"]:
    blocks = page.get("blocks")
    if not isinstance(blocks, list) or not blocks:
        review.append({"page": page["index"], "reason": "missing_blocks"})
        continue
    for index, block in enumerate(blocks):
        scores = block.get("confidence_scores") or {}
        score = scores.get("minimum_content_confidence_score")
        known = type(score) in (int, float) and math.isfinite(score) and 0 <= score <= 1
        if not known or score < threshold:
            review.append({
                "page": page["index"],
                "block": index,
                "reason": "low_or_missing_score",
            })
print(json.dumps(review, ensure_ascii=False, indent=2))
0.90 只是演示阈值,不是官方推荐,更不是“90% 正确”。实际阈值要用自己有人工答案的文档来调整,且分数策略不能取消关键字段复核。脚本按 0–1 范围检查分数,范围不符也进入待核。本文用合成响应验证了高低分、缺分、空块、非法值等分支,未验证真实 OCR 效果。
候选清单还应连回保存的原始结果和原件,使用页面索引、块序号与边界坐标定位。页面索引转成人看的页码时保留映射;裁剪过原件,更不能把新第一页标成原合同第一页。
复核后,怎么让知识库用到正确版本?
复核应留下原件、原始 OCR、修订文本和修订状态之间的对应关系,再把确认后的版本送入索引。
如果人工修正了一个金额,却仍用旧向量索引回答,模型可能继续引用旧数字。先给资料与修订版本一个稳定身份,重建受影响片段,再用明确问题检查召回结果与出处。版本管理可读按制度版本检索;最后给知识库加几道资料里没有答案的题,确认系统没有把缺失内容补成确定结论。
本文使用的是 Mistral 官方 OCR 协议。Nbility 的模型目录说明与向量接口可帮助规划后续模型接入,但不代表本文已经核实本站提供相同 OCR 块级接口。先把一份公开文档的提取、定位与复核走通,再扩大处理规模。