一天只用几次的长提示词,什么时候值得开 12 小时缓存
OpenAI Responses API 新增 12 小时提示缓存,写入按输入价 2.5 倍计。用倍数算清它和默认 30 分钟缓存、不缓存的盈亏点,并给出混合断点的写法和账单字段。
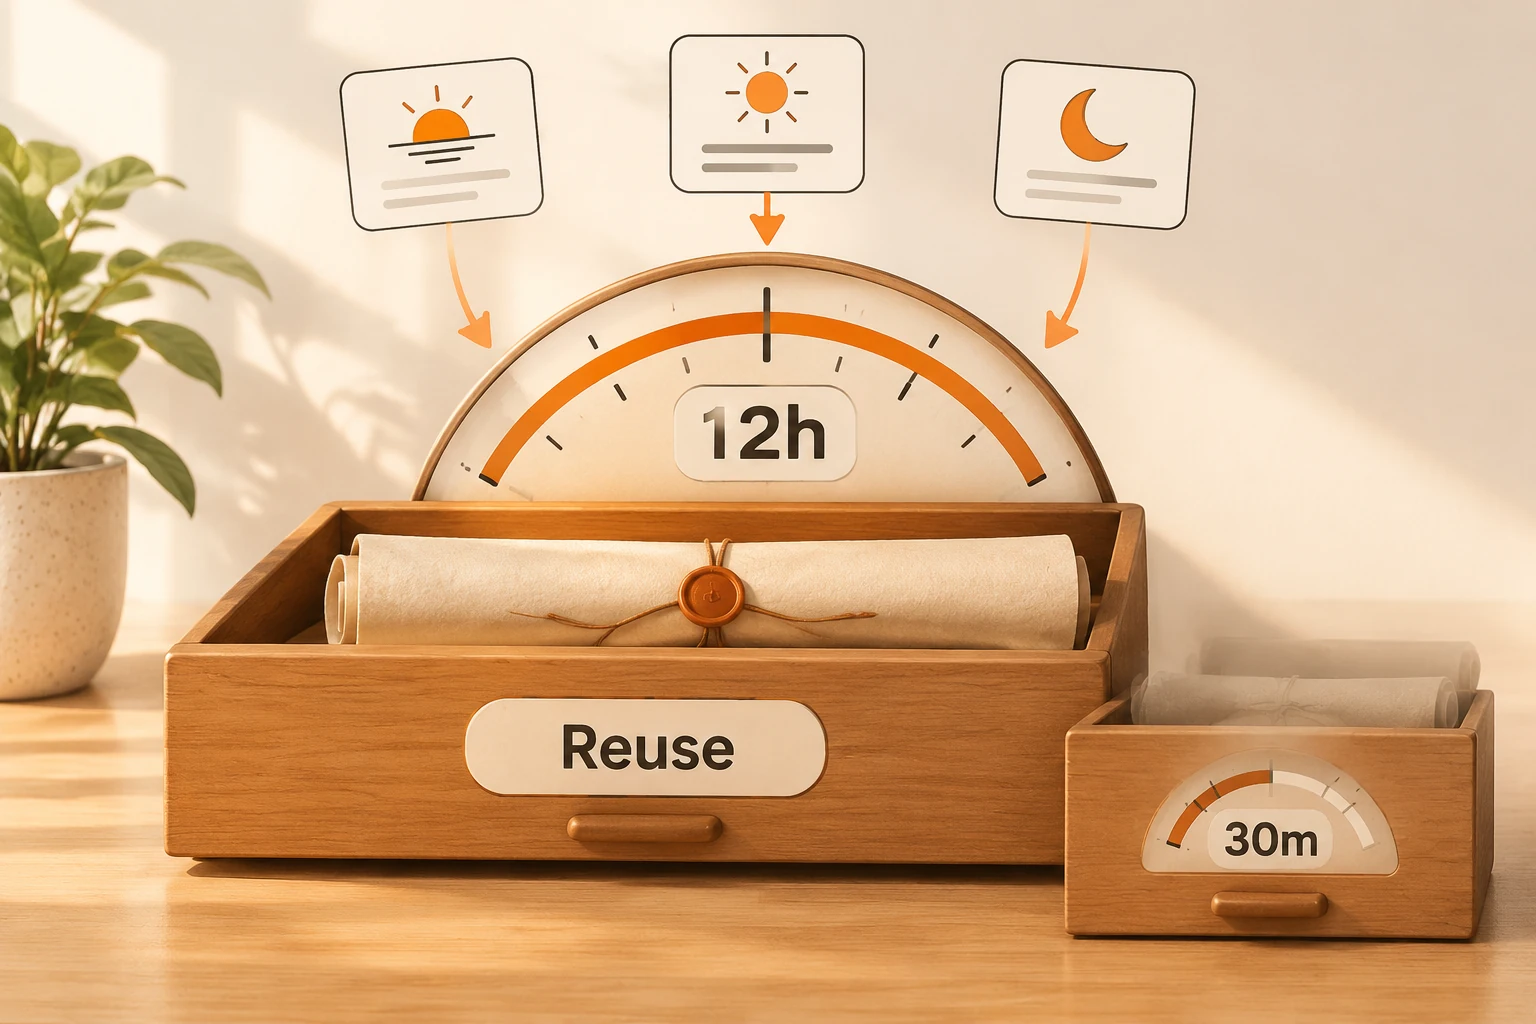
有些应用的提示词很长,但调用并不密集:一个内部知识助手,固定带着两万 Token 的制度文档,一天被问三五次;一个每天上午、下午各跑一次的报表任务,每次都带同一套说明和表结构。默认缓存的有效期是 30 分钟,两次调用隔几个小时,缓存早就过期,每次都要重新写入。
OpenAI 在 2026 年 10 月 20 日给 Responses API 加了 12 小时的缓存选项。它的写入更贵,所以要先算一下:一天用几次才划得来。
本文于 2026 年 11 月 15 日核对 OpenAI 的更新记录与提示缓存指南。下面的计算用“处理一次完整前缀的普通输入费用”作单位,没有发起真实请求,也不涉及具体模型单价。
规则先说清楚
适用于 GPT-5.6 及以后的模型:
| 项目 | "30m"(默认) | "12h" |
|---|---|---|
| 最短有效期 | 30 分钟 | 12 小时 |
| 写入价 | 普通输入的 1.25 倍 | 普通输入的 2.5 倍 |
| 读取价 | 普通输入的 0.1 倍 | 同左 |
| 怎样启用 | 默认,不必设置 | 在 Responses API 中设置 |
在 GPT-6.1 Sol 和 GPT-6.1 Terra 上,读取价是 0.05 倍。两种写入价都是总价,不是在普通输入之外再加。可缓存的前缀至少 1,024 Token。
几条容易误解的规则:
- 12 小时是最短有效期,决定的是在这段时间内能否按读取价计费;它不保证每次都真的复用、也不保证延迟更低,同时不改变数据保留政策的上限。
- 30 分钟缓存会被读取续期。 每次命中都把有效期延到读取后至少 30 分钟。调用间隔一直短于 30 分钟时,默认档位就足够了。
- 从 30 分钟升级到 12 小时要重新付全额写入,之前的 30 分钟写入不抵扣。
用倍数算盈亏点
设一次完整前缀按普通输入计费为 1。调用间隔都超过 30 分钟、但都在 12 小时之内,第 N 次使用时累计费用:
| 当天使用次数 | 不缓存 | 默认 30 分钟(每次重新写入) | 12 小时(写一次,之后读取) |
|---|---|---|---|
| 1 | 1 | 1.25 | 2.5 |
| 2 | 2 | 2.5 | 2.6 |
| 3 | 3 | 3.75 | 2.7 |
| 4 | 4 | 5 | 2.8 |
12 小时一栏的算法是 2.5 + 0.1 × (N − 1);读取价为 0.05 倍的模型是 2.5 + 0.05 × (N − 1),结论相同:
- 只用 1–2 次时,12 小时缓存比不缓存还贵。
- 从第 3 次起它开始比不缓存便宜,第 4 次时只花不缓存的七成。
- 间隔超过 30 分钟的场景里,默认 30 分钟缓存每次都要按 1.25 倍重写,反而比不缓存更贵。
这张表只计算可缓存前缀那一部分,每次不同的问题和输出另算。它也假设前缀完全不变;改一个字、调整工具列表顺序,都会让后面的部分无法命中,原因可回看三家缓存账单的对比。
同一请求里分开设置两种有效期
全天都用的说明给 12 小时,会话里几分钟内反复用到的内容给 30 分钟,当前问题不写入缓存。官方示例用显式模式:
{
  "model": "YOUR_MODEL",
  "prompt_cache_options": {"mode": "explicit", "ttl": "30m"},
  "input": [
    {
      "role": "developer",
      "content": [{
        "type": "input_text",
        "text": "全天复用的说明和参考资料……",
        "prompt_cache_breakpoint": {"mode": "explicit", "ttl": "12h"}
      }]
    },
    {
      "role": "user",
      "content": [
        {
          "type": "input_text",
          "text": "接下来几分钟会反复用到的会话内容……",
          "prompt_cache_breakpoint": {"mode": "explicit"}
        },
        {"type": "input_text", "text": "本次问题,不需要写入缓存"}
      ]
    }
  ]
}
请求级 ttl 作用于没有自己 ttl 的断点;单个断点上的 ttl 可以覆盖它。显式模式下,最后一个断点之后的内容按普通输入计费,不产生写入费。顶层 instructions 不能放断点,要缓存的说明请放进 developer 消息的 input_text。每个请求最多产生四次缓存写入。
从账单字段核对
响应的 usage.input_tokens_details 里:
cached_tokens:按读取价计的 Token;cache_write_tokens:写入总数,其中cache_write_tokens_details.ttl_30m_tokens和ttl_12h_tokens分别列出两种写入。
这些都已包含在 input_tokens 里,不要重复相加。官方算例:输入 12,000 Token,其中读取 4,000、30 分钟写入 3,000、12 小时写入 4,000,普通输入价 $1/百万 Token、读取价 $0.10:
(1000 + 4000 × 0.1 + 3000 × 1.25 + 4000 × 2.5) / 1,000,000 = $0.01515
其中 1,000 是 12000 − 4000 − 7000 得到的普通输入。上线后第一天就看 ttl_12h_tokens:如果它每次请求都很大,说明前缀没有被复用,可能是内容在变,或请求根本没走到 12 小时断点。
经由 Nbility 调用
本站的 Responses 接口会转发 prompt_cache_options,当前网关代码也会把 12 小时写入单独计价,而不是混进 30 分钟写入。是否真的命中取决于所选模型和渠道;本文没有对本站做实测。核对一次请求花了多少,可以在用量记录里看缓存读取与写入,再对照计费说明。客户端显示的估算和最终扣费可能不同,原因见用量与账单对不上时。
简单的判断方法:同一份长前缀,当天会在 12 小时内被用到 3 次以上、且间隔常超过 30 分钟,就值得试 12 小时;否则留在默认档位。