OpenCode 自动压缩以后,还能记住哪些内容
OpenCode V2 压缩会保留摘要和近期对话;keep.tokens、buffer 与摘要模型分别影响细节、触发时机和调用路径,不能靠调大窗口解决所有超限。
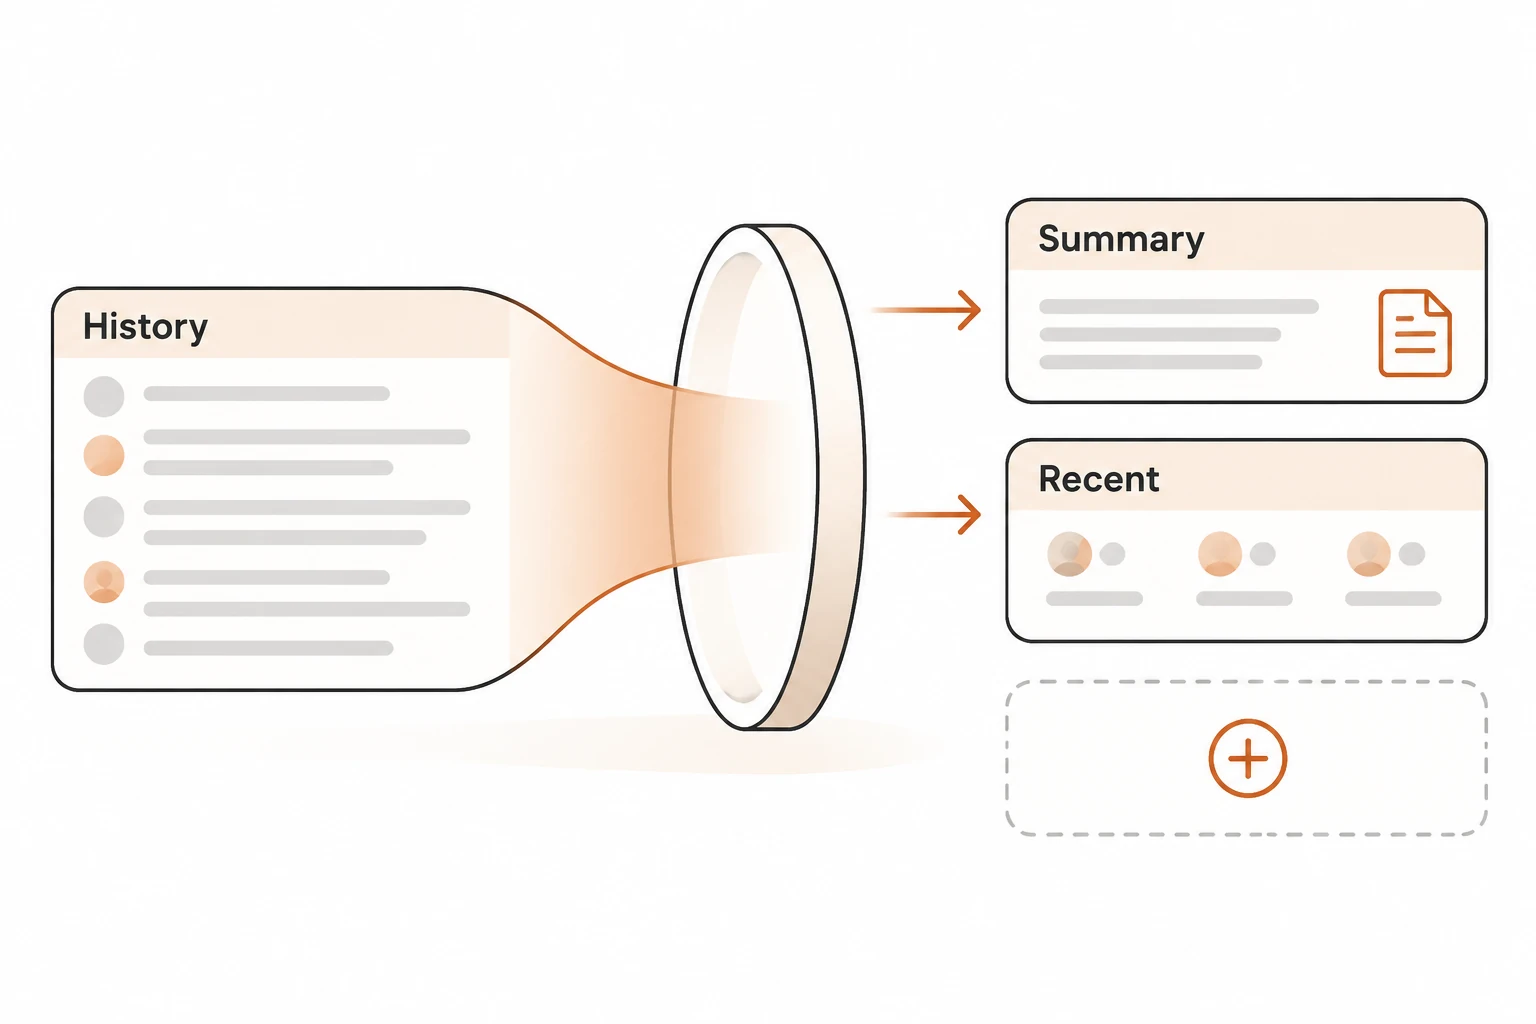
OpenCode V2 的自动压缩会用摘要替换较早的对话,同时保留一段近期内容。默认的 keep.tokens 是约 15,000 Token;它保留的是近期对话预算,不是“永久记住 15,000 Token 的全部原文”。长工具输出、附件和摘要本身都可能丢失细节,重要要求仍应落到可重新读取的文件里。
本文于 2026 年 11 月 21 日核对官方压缩文档与 v2.3.2 标签中的同页说明。这是 V2 的机制与配置解释,未运行真实模型长会话测试。若你刚开始使用,可先完成OpenCode 接入检查,再看下面的会话管理。
压缩后,磁盘记录与模型看到的内容一样吗
不一样。较早消息仍可留在会话存储里,却不再逐条发给模型。V2 的本地摘要会概括目标、要求、决定、已完成工作、阻塞和下一步;旁边还保留近期对话,以便模型继续当前动作。
官方说明还给出两个容易忽略的变化:近期保留部分里的长工具输出会被缩短,附件数据会换成简短描述;压缩之后,当前版本的指令文件会成为会话的新基础。所以“界面还能翻到那条消息”不能证明模型本轮收到了它,“之前看过截图”也不能证明它仍能读到截图里的小字。
对持续几天的工作,把这些内容写进项目允许保存的位置:实际目标、不能破坏的约束、已验收结果、正在修改的文件和下一步。不要把凭据或整段私人聊天复制进去。需要多次重复的操作可拆成按需加载的 Skill,让模型在相关任务到来时重新读取。
keep.tokens 和 buffer 应该怎么调
keep.tokens 决定保留多少近期内容,buffer 决定在窗口里提前留多少空位。两者增大后的效果不同:前者保留更多近期细节,也挤占新工作的空间;后者让压缩更早发生。
在项目的 opencode.json 放一个最小 V2 示例:
{
  "$schema": "https://opencode.ai/config.json",
  "compaction": {
    "auto": true,
    "keep": { "tokens": 15000 },
    "buffer": "20%"
  }
}
"20%" 表示留出约 20% 的窗口,在约 80% 满时触发;不是用到 20% 就压缩。按官方文档的简化例子,128k 窗口对应约 102k,1M 对应约 800k。这是机制算例,真实可用输入还要考虑模型输出等预算。
默认 buffer 为 "15%",至少留出约 16k;也接受 Token 数。不要把配置中的窗口改成一个模型实际不支持的大数。客户端声明不会扩展服务端容量,上下文超限说明解释了这种差别。
若近期精确细节总丢失,可以小幅增加 keep.tokens,再用同一类任务观察;若压缩请求自己已超限,应检查触发是否太晚、工具定义与固定指令是否过大。一次只改一项,别同时换模型、窗口和工具后猜哪项生效。
主聊天成功,摘要为什么还会失败
本地摘要默认使用会话模型,也可以通过 agents.compaction.model 指向另一个已配置模型:
{
  "agents": {
    "compaction": {
      "model": "your-provider/your-summary-model"
    }
  }
}
这里两个名称都是占位符,须换成实际已配置且有权使用的 ID。官方说明是:模型无法解析时会回退到会话模型;不要把它理解成任意认证失败、限流或协议错误都会自动换模型重试。
默认还会提前在后台准备摘要。摘要尚未应用时,会话可以继续;但这次摘要请求已经消耗 Token,即使会话提前结束、最后没用上它。若想只在到达压缩时再生成,可设置 compaction.background: false。这改变等待与调用时机,本文没有测量它能节省多少钱。
原生压缩是另一条路径:providers.<id>.settings.compaction.type 设为 native,让支持的提供方返回不透明的加密检查点。官方限定为支持该能力的 Responses 模型,部署和模型仍有差异。这个检查点只适用于同一提供方和模型;换模型后会回到原始对话继续,不能把它当成通用交接文件。
使用 Nbility 时,先按接入基础确认协议和真实模型能力;普通对话能成功,不足以证明该路径也支持原生压缩。不确定时保留本地摘要方式,另做小会话验证。
已经压缩了,为什么仍会超限
压缩只能替换可压缩的历史。若输入主要是固定指令和工具 Schema,剩下的历史再短也腾不出多少空间。官方用“128k 窗口里有 120k 固定指令与工具、8k 对话”说明这个限制。
先删去不相关的工具入口,按任务分配 MCP 工具,再检查过长的常驻说明。服务端报请求过长时,官方说明会尝试压缩并重试一次,第二次仍拒绝就返回错误;这不是无限重试保证。
近期 #65146 报告原生压缩遇到 WebSocket 续接拒绝后,没有按预期完整重试。报告环境写的是 2.3.0 及 dev 提交;机器人回复使用模拟服务,未跑真实提供方。截至查阅仍开放,本文未复现,不能据此断言所有压缩失败都由这个问题造成。
怎样确认压缩后的任务还能继续
用公开演示仓库写下三条能核对的约束,例如不能改哪个文件、测试命令是什么、下一步要处理哪个边界。压缩完成后要求模型列出这些约束并说明来源,再让它完成一个小的后续动作,检查实际 diff 与测试结果。仅说“我记得”不算通过。
需要手动触发时,官方给出的 V2 命令如下,先把 ses_example 换成当前会话 ID:
opencode api post /api/session/ses_example/compact --data '{}'
返回只代表请求被接受;完成要看 session.compaction.* 事件。compaction.auto: false 仍允许手动压缩,也不会删除已有检查点。别为了做实验删除会话数据库或反复重发正在执行的任务;先把目标和验收要求保留下来,再恢复长任务。