让 Claude 在难处请教顾问,执行仍交给原来的模型
Claude Advisor tool 让执行模型在生成中向顾问模型求助。顾问读取完整会话但不运行工具,用量、输出上限、错误和暂停续接需要单独处理。
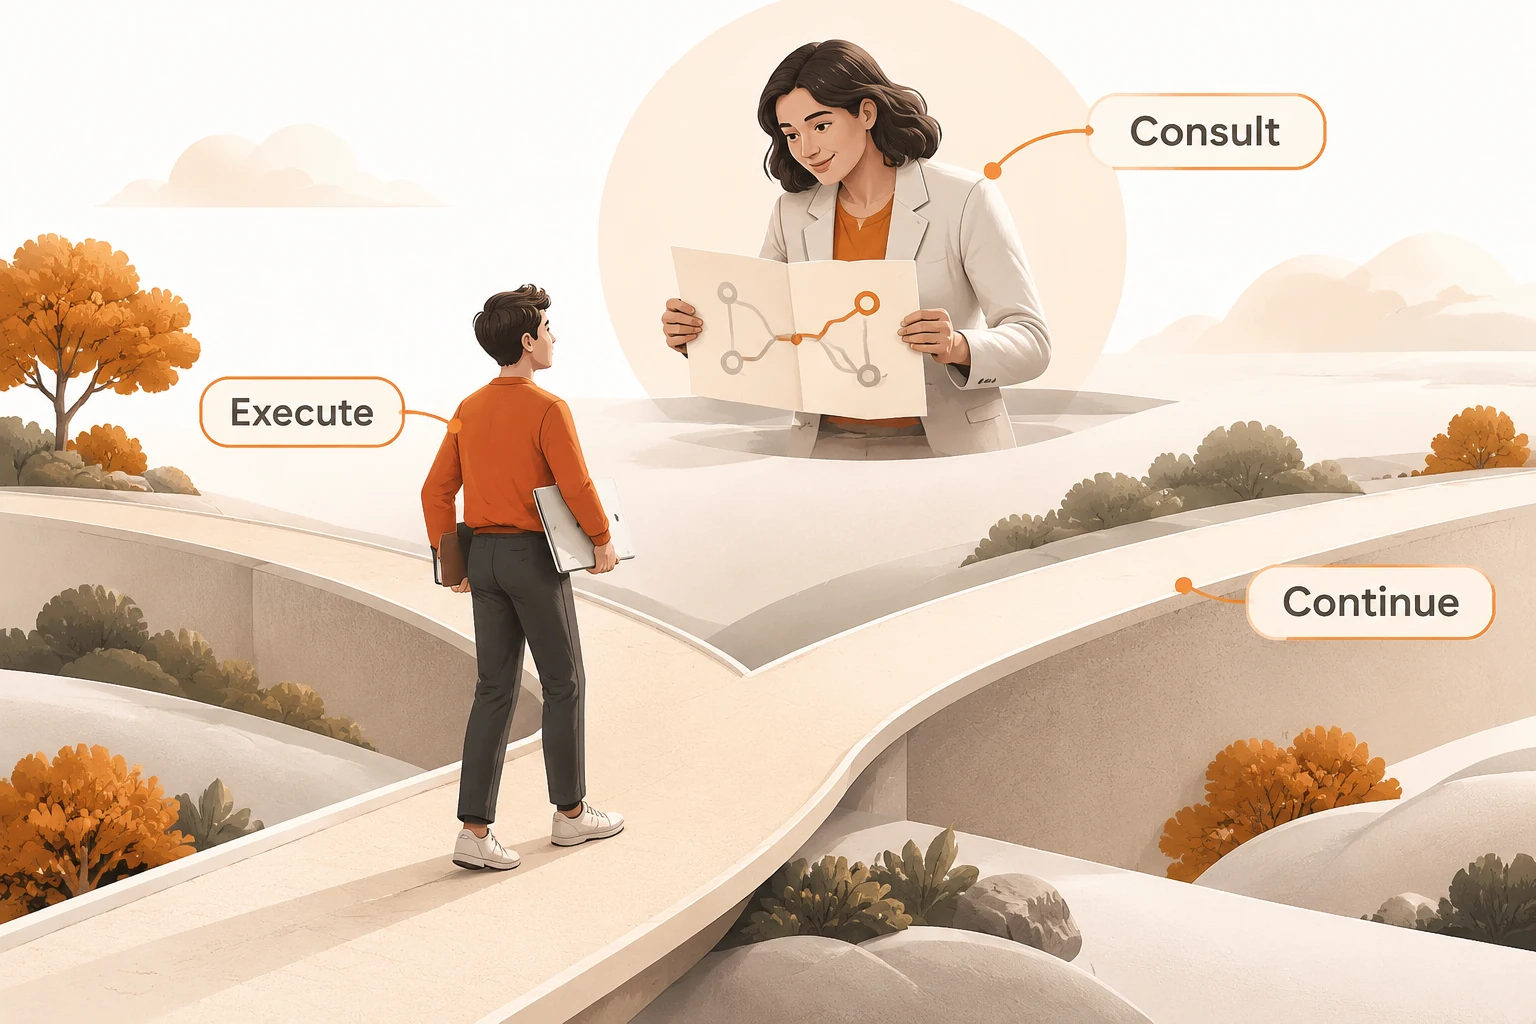
一项开发任务常有两种工作:判断该从哪里下手,以及按确定的方向读文件、改代码、验证结果。Claude 的 Advisor tool 允许执行模型在需要时向另一个模型请教,然后继续自己完成任务。顾问不会接管终端,也不会替你运行工具。
这适合试验“多数步骤交给较轻模型,关键判断请更强模型参与”的工作方式。是否真的更划算,要看任务完成情况与两边的总用量,不能只比较模型单价。本文于 2026 年 11 月 22 日核对官方 Advisor 指南和11 月 9 日模型更新。没有运行真实顾问调用或做效果对照。
顾问会看到什么,又能做什么?
顾问会收到执行模型的完整会话作为引用上下文,包括系统提示、工具定义、先前工具结果,以及本轮已经生成的内容;顾问本身没有工具,也不做上下文管理。
执行模型决定何时调用 advisor。服务端发起单独的顾问推理,把建议放回 advisor_tool_result,执行模型再继续生成。通常这一过程发生在同一个 /v1/messages 请求内部;暂停续接是另一个需要处理的分支。
因此它与多个 Agent 使用不同工作目录不是同一件事。后者涉及谁改文件、谁提交与怎样合并;Advisor 主要改变某个执行模型获得建议的方式。不要期待它提供独立审查仓库、并行运行测试或另一份文件副本。
完整会话会进入顾问推理,也意味着接入前要按同一数据边界核对模型和平台,不能只审查执行模型的可用性。
最小请求应该怎么写?
Messages API 当前使用 advisor_20260301 工具,并要求 advisor-tool-2026-03-01 beta 标头。下面沿用官方支持的 Sonnet 5 执行、Opus 5.5 顾问组合,增加本轮次数与单次顾问输出限制:
import anthropic

client = anthropic.Anthropic()
response = client.beta.messages.create(
    model="claude-sonnet-5",
    max_tokens=4096,
    betas=["advisor-tool-2026-03-01"],
    tools=[{
        "type": "advisor_20260301",
        "name": "advisor",
        "model": "claude-opus-5-5",
        "max_uses": 2,
        "max_tokens": 2048,
    }],
    messages=[{
        "role": "user",
        "content": "Review a proposed CSV import design. Explain validation order, duplicate handling, and how to test failure recovery. Do not access external systems.",
    }],
)
print(response.model_dump_json(indent=2))
这段示例需要官方 ANTHROPIC_API_KEY,本文只做 Python 语法检查。它没有提供文件工具,所以也不会读取一个实际仓库。工具被声明,不保证执行模型每轮都会调用它;验收时要检查响应块,而不是从最终回答风格推断“顾问参加过”。
max_uses 限制的是一整轮顾问调用,续接 pause_turn 或只交回工具结果的多个请求可能仍属于同一轮。顶层 max_tokens 管执行模型输出,工具内的 max_tokens 管顾问单次输出,包含思考与文本,当前最小值是 1024。两处设置不能互相替代。
换成 Fable 5.2 时,顾问组合还能照搬吗?
Fable 5.2 作为执行模型时,当前只能接受 Fable 5.2 或 Mythos 5.2 顾问;把执行模型名换掉、保留原来的 Opus 顾问,会返回 400。
其他执行模型也有各自的配对列表,不能用“模型更大”或名称里的数字判断。应按官方兼容表检查顶层 model 与工具内 model 两项。Fable 的定位可看模型选择文章,实际可用范围仍须按自己的组织与平台确认。
顾问结果也不一定是可读文本。Opus 5.5 等模型返回 advisor_redacted_result,内容是 encrypted_content;部分较早模型返回 advisor_result 和明文 text。客户端不能把“不含 text”当作失败,更不能尝试解析密文或用空字符串替换它。后续请求应原样保留整个结果块。
为什么普通用量数字看不见顾问?
顶层 usage 的 Token 合计只反映执行模型,顾问用量列在 usage.iterations[] 中的 type: "advisor_message" 项,并按顾问模型计价。
核对总用量时,应把 message 执行迭代与 advisor_message 顾问迭代按各自模型分开记录。不能先把执行迭代求和,再加一次顶层合计,那会重复计算。缓存输入和普通输入也保留各自口径,不能从“顾问只给了几句话”推断调用很便宜。
这里没有真实账单,所以不提供节省比例。比较方案时,固定同一任务和完成条件,记录是否完成、返工、调用次数、总耗时与完整用量;方法见模型效果观察与Agent 多次调用。顾问建议如果减少了后续试错,才有机会抵消额外调用。
顾问失败或暂停时,执行会怎样?
顾问内部报错不一定让整个 HTTP 请求失败。advisor_tool_result_error 可以表示超出次数、限流、容量不足或上下文过长,执行模型收到错误后仍会继续。
如果业务要求重要任务必须经过顾问,不应只看 200 或最终文本。应用应检查是否有成功的顾问结果,并对没有完成顾问检查的产物标记待核。
stop_reason: "pause_turn" 还可能留下只有 server_tool_use、暂时没有顾问结果的响应。按官方规则把 assistant 内容原样接回历史,携带相同的顾问工具和 beta 标头再次请求;不要自己伪造顾问 tool_result。若同时有自己的工具等待执行,则按 tool_use 分支交回工具结果。
长会话里修改顾问工具的模型、上限或缓存配置,还会改变 thinking 前缀。相关风险见Fable 思考块前缀检查。在独立测试会话里先确定配置,比运行到一半为省一次调用临时改工具更容易验证。
本站Claude 兼容说明没有承诺所有服务端 beta 工具都可用。经网关接入时,要单独确认 beta 标头、顾问结果块与完整用量能否保留;本文不把官方能力当作本站已经验收的功能。