Antigravity Agent 换成 Hydrogen 做默认模型,计费仍按整轮任务算
11 月 12 日起,Gemini Managed Agents 的 Antigravity Agent 默认改用 gemini-4-hydrogen。模型可以在 agent_config 里固定,预算靠 max_total_tokens,费用按整轮自主循环的 token 与工具算,不是一次问答的价。
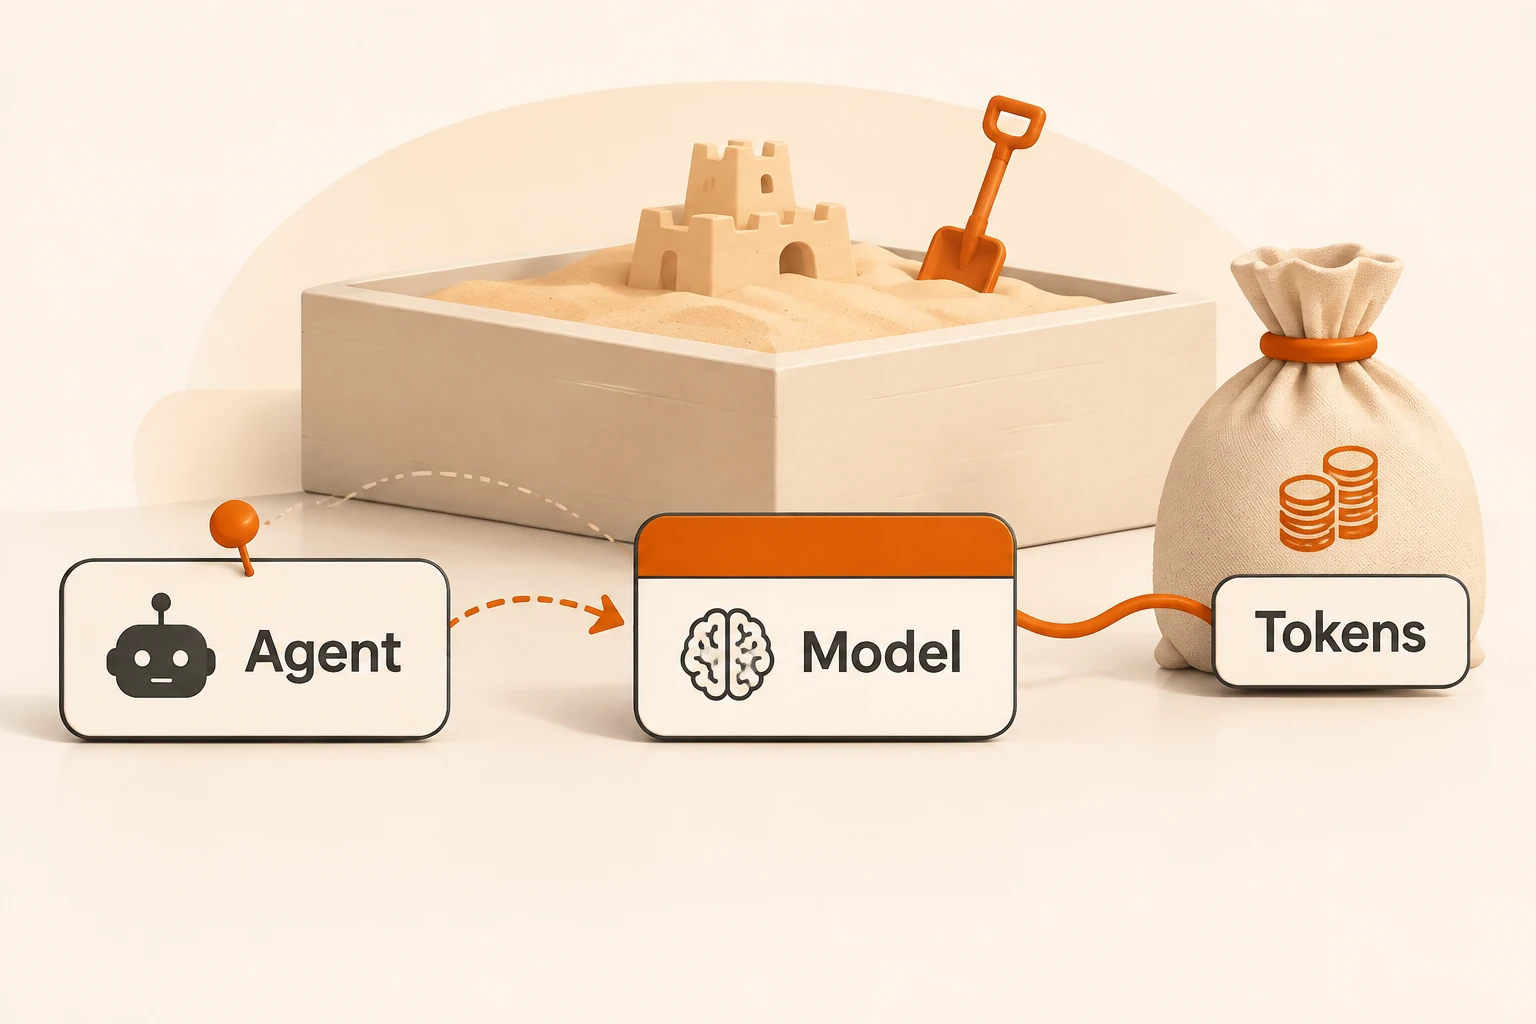
Gemini API 的 Antigravity Agent 从 11 月 12 日起默认使用 Gemini 4 Hydrogen(gemini-4-hydrogen)做推理,模型可以在 agent_config 里换成 Carbon、Argon 或 Flash 系列。它按整轮自主循环消耗的 token 和工具计费,一次交互通常要几十万到几百万 token;预览期间沙箱算力不收费。
这两个结论决定了接入前要检查什么:默认模型会随官方变化,预算要自己设上限,费用要按任务算而不是按提问数算。
Antigravity Agent 和 Antigravity IDE 是什么关系
两者共用一个 agent harness。官方文档的原话是,Antigravity Agent “uses the same harness as the Antigravity IDE”:同样的工具、同样的 agent 循环、同样的上下文管理方式,只是 API 版跑在 Google 托管的 Linux 沙箱里,由一次 API 调用启动。
这意味着:
- IDE 里的经验可以带过来,比如怎么写
AGENTS.md、怎么组织 skills; - 排错不能直接套。IDE 是本地客户端,API 版是服务端沙箱,报错、配额、网络出口都不在同一个位置。
如果你在中文社区看到“agent execution terminated due to error 怎么解决”这类问题,先确认它出自哪一边。Google 开发者论坛里那条从 2026 年 1 月 15 日开始的讨论帖 Antigravity broken, getting only "Agent execution terminated due to error" 归在 Google Antigravity(桌面 IDE)分类下,不是 Gemini API。用户报告所有模型都失败,日志里出现过 429 限流、登录状态刷新失败等不同线索,重启、重新登录、清本地配置都试过,帖子里没有官方结论。
对 API 版来说,可控的状态和错误字段在 Interactions API 的返回里,排查从那里开始,不要照搬 IDE 的清理步骤。两边的关系在 Antigravity 接入说明和 Antigravity CLI 条目里也分开写了。
默认模型变了,已有代码会怎样
antigravity-preview-09-2026 这个 agent 名称没变,变的是它省略 agent_config 时使用的模型。也就是说,不写 model 的调用方,请求会悄悄换成 Hydrogen 来推理。
对大多数任务影响不大,但有三处需要留意:
| 项目 | Gemini 4 Hydrogen | 需要确认的地方 |
|---|---|---|
| 思考档位 | 默认 high,另有 low/medium/xhigh | agent 的 agent_config 不暴露 thinking_level,只能通过换模型来调整 |
| 上下文窗口 | 统一 1M,输入、思考、输出共用一个窗口 | 与 3.8 Flash 的“1M 输入 + 64K 输出”分开口径不同 |
| 缓存 | 不支持显式缓存,隐式缓存自动生效 | 不要传 cached_contents |
Hydrogen 的单价是每百万输入 token 1.50 美元、输出 7.50 美元。换成 Carbon 或 Argon 会改变单价和默认思考档位,这一点在 Gemini 4 Hydrogen 迁移那篇里已经按迁移场景写过;这里只关心它作为 agent 默认值带来的影响。
怎么把模型固定下来
在 agent_config 里写 model 就会覆盖默认值。官方示例用的是 Carbon,适合复杂的软件工程和推理任务:
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

interaction = client.interactions.create(
    agent="antigravity-preview-09-2026",
    input="把 /workspace/data.csv 的缺失值处理掉,输出一份处理说明。",
    environment="remote",
    agent_config={
        "type": "antigravity",
        "model": "gemini-4-carbon",
        "max_total_tokens": 200000,
    },
)
print(interaction.status)
print(interaction.usage.total_tokens)
agent_config.model 当前支持的值:
| 值 | 定位 |
|---|---|
gemini-4-hydrogen | 默认,日常编码与 agent 任务,速度快 |
gemini-4-carbon | 最强推理,适合复杂工程和长链路任务 |
gemini-4-argon | 前沿推理,单轮 token 花费低于 Carbon |
gemini-3.8-flash | 3.8 代的均衡选择 |
gemini-3.6-flash | 通用 agent 流程 |
gemini-3.5-flash-lite | 低延迟、成本敏感 |
用 agents.create 建固定 agent 时,模型在创建那一刻就锁定了,之后每次交互不能覆盖。这对生产环境是好事:不会因为官方改默认值而悄悄换模型;代价是升级要新建 agent,而不是改一次请求参数。
费用按什么算
一次 Antigravity 交互不是一次问答。agent 会反复规划、调工具、跑代码、看结果,直到任务结束。官方给出的 token 区间是每次交互通常 10 万到 300 万 token,计费包含:
- 输入、输出,以及 agentic 循环里产生的中间输入和推理 token;
- 工具使用,按现有定价结构计(Google 搜索返回的 token 不计,
url_context等工具抓取的 token 计入); - 沙箱算力(CPU、内存、执行)在预览期间不计费。
官方按任务类型给了估算,数据来自他们自己的运行记录,不是第三方复测:
| 任务类型 | 输入 token | 输出 token | 典型费用 |
|---|---|---|---|
| 资料研究与信息综合 | 10 万–50 万 | 1 万–4 万 | $0.30–$1.00 |
| 文档与内容生成 | 10 万–50 万 | 1.5 万–5 万 | $0.30–$1.30 |
| 流程与系统设计 | 10 万–40 万 | 1 万–3 万 | $0.25–$0.80 |
| 数据处理与分析 | 30 万–300 万 | 3 万–15 万 | $0.70–$3.25 |
表格里有两条容易被忽略的说明:50%–70% 的输入 token 通常命中缓存;工具调用特别多的复杂任务,单次交互可能累积 300 万到 500 万 token,费用接近 5 美元。
把这张表当成量级参考更合适。同样的提示词,模型不同、工具调用次数不同,落点会在区间两端之间移动。要复算自己的一笔,用返回里的 usage.total_tokens 和当前模型单价,乘出来的才是这次的实际成本;Carbon 和 Hydrogen 分工那篇讲了同一条思路:按任务定模型,而不是按单次调用数估钱。
给自动任务加预算上限
agent_config.max_total_tokens 限制一次交互能花掉的 token 总量,包含输入、输出和思考,缓存命中的 token 不计入。
interaction = client.interactions.create(
    agent="antigravity-preview-09-2026",
    input="分析 /workspace/data.csv 并生成一份摘要报告。",
    environment="remote",
    agent_config={
        "type": "antigravity",
        "max_total_tokens": 50000,
    },
)
if interaction.status == "incomplete":
    print("预算用完,token:", interaction.usage.total_tokens)
到上限时,交互以 status: "incomplete" 结束,模型的进度和上下文都保留。用 previous_interaction_id 加原 environment_id 再发一次,就能从中断处继续,新的一次交互有独立的预算。
这个上限是“尽力而为”:agent 在步骤之间检查预算,实际用量可能略微超出,别把它当成精确的停止点。
也就是说,预算控制靠两道:单次交互设 max_total_tokens,应用侧对 total_tokens 做累计统计,接近账户还是项目额度就停下。让 Agent 每晚自动跑之前先给一笔能停下来的预算里写的预留与停止思路,同样适用于这里。
接入前要核对的几件事
- 模型是否固定:省略
agent_config.model时,默认模型会随官方发布变化。对结果稳定性有要求时,显式写死模型,或用agents.create锁定。 - 不能被改的参数:
temperature、top_p、top_k、stop_sequences、max_output_tokens在该 agent 上会返回 400。想调输出长度,用max_total_tokens和后台执行,而不是max_output_tokens。 - 暂不支持的能力:结构化输出、
file_search、computer_use、google_maps;音频、视频和文档不能作为输入,只能传文本和图片。 - 函数调用只能是有状态的:必须用
previous_interaction_id续接,手工重建历史不被支持。自己维护对话的记录方式要改。 - 后台执行依赖存储:
background=True要求store=True,这正好是 Gemini 新项目默认存请求里那条默认值变化涉及的地方,部署前一起确认。 - 环境寿命:环境闲置 7 天后会被永久删除,虚拟机闲置会关机,下次请求冷启动恢复。
常见疑问
API 里的 Antigravity Agent 和 IDE 里的 Agent Manager 是同一套东西吗? 共用同一个 harness,但运行位置、错误表面和配额来源不同。IDE 的报错处理步骤不能直接用在 API 上。
不写 model 会怎样? 使用当前默认模型,目前是 gemini-4-hydrogen。官方再次调整默认值时,不写 model 的代码会跟着变。
能设置思考档位吗? AntigravityAgentConfig 目前只有 type、model、max_total_tokens 三个字段,文档没有提供 thinking_level。要更深或更浅的思考,只能换模型;想知道 Hydrogen 各档位的差别,看 Hydrogen 迁移那篇。
预览期间沙箱不收钱,是不是就可以随便跑? 不是。token 和工具照样计费,一次复杂任务可能到 5 美元;算力免费只是省掉了环境那一块。
下一步
如果只是想让 agent 干一件事,可以直接用 Nbility 的 Gemini 兼容接口发请求,沙箱由你的应用自己安排;如果需要托管沙箱和文件系统,就按上面的顺序检查:先固定模型,再设 max_total_tokens,最后在日志里记录 usage.total_tokens 和交互状态。这样默认模型再变,费用和结果至少还是你能对上的。