用一句话改声线,Gemini 会另存一把声音
Gemini Voice remixing 用相对描述修改已有声音,生成独立 voice ID。分清长期声线与临时表演,并为试听、版本、项目范围和到期时间留下记录。
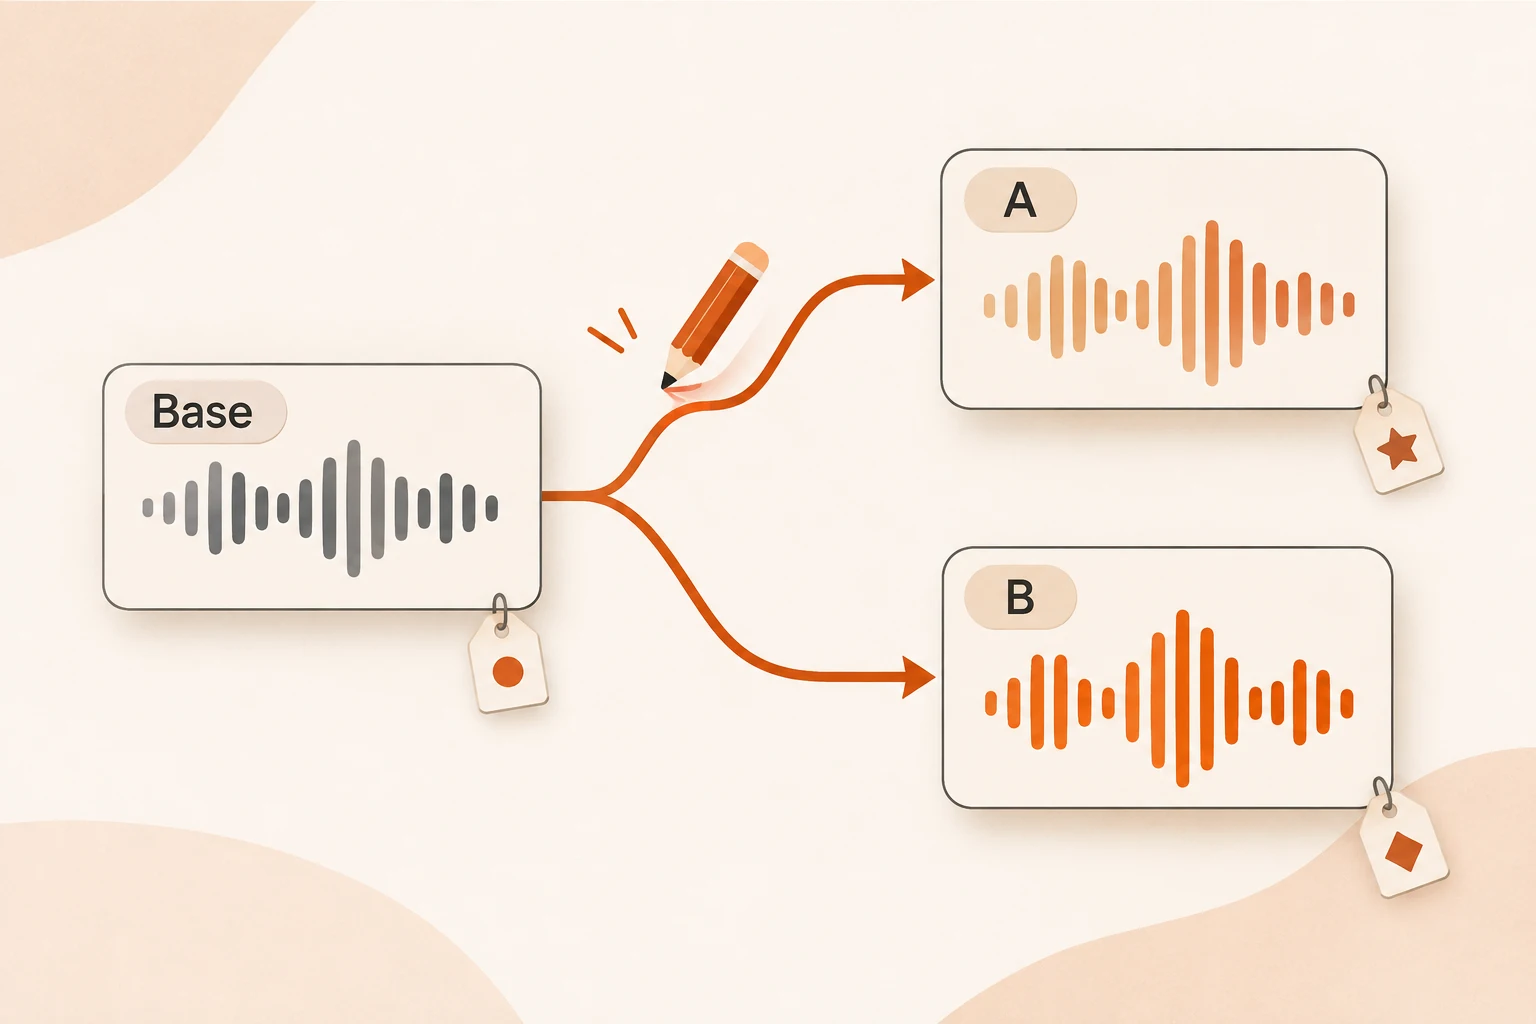
一段课程旁白已经选好了声音,只想让它沉稳一点、少一点兴奋感,过去可能要重新写整套声线描述。Gemini 在 11 月 4 日推出的 Voice remixing 提供了另一种方式:选一把已有声音,只描述要改的部分,生成一把新的、可以重复使用的声音。
关键在“新的”。Remix 不会覆盖原声线,每次都会创建独立的 voice_... 资源。这样可以保留原版和几个候选,但也需要管理版本,不能把每次试错都当作原对象上的一次保存。
本文于 2026 年 11 月 11 日核对更新记录、Voice remixing 指南和语音合成文档。没有生成或试听音频,下面的提示和流程是创作方案,不是音质、中文发音或方言效果报告。
先决定改的是声线,还是这句话的语气
声音设计里有两个不同问题:“这个角色平时怎么说话”,以及“这一句怎样表演”。前者适合保存成声线,后者通常放在本次合成的风格指令里。
| 想做的调整 | 对应方式 | 是否需要新声线 |
|---|---|---|
| 以后都更成熟、音色更低 | Remix 的相对描述 | 创建新 voice_... |
| 这一句轻声说、下一句兴奋 | speech_metadata.style | 复用当前声音 |
| 从零设计一个角色 | Voice design | 走声音设计流程 |
| 依据真人录音复制声音 | Voice replication | 独立流程,需要相应授权 |
最后两项是相邻能力,不是 Remix 的另一个参数。本文使用预置声音,不拿真人录音示范,也不把“保持原有声音特征”的指令写成身份一致的保证。
对课程、播客或产品解说,先把稳定的人物声音定下来,再给少数段落加表演指令,通常比每一段都另建声音更容易维护。若目标是能听、能回答、能调工具的助手,还要另看Voxtral 的完整语音任务链,声线只是其中一个环节。
创建模型与合成模型分开记
官方接口使用 POST /v1beta/voices 创建 Remix,创建模型为 gemini-3.8-flash-tts。得到的 stored voice 可以用于 gemini-3.8-flash-tts 和 gemini-3.8-flash-lite-tts 的语音合成。不要因为后者能合成,就推导它也能承担声音创建。
下面是按当天官方原生协议写的完整创建请求,本文未执行。使用有权限的 Google 项目与对应 Key;它不是向 Nbility /v1/audio/speech 发送的请求:
curl --fail-with-body \
  https://generativelanguage.googleapis.com/v1beta/voices \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "store": true,
    "voice": {
      "model": "gemini-3.8-flash-tts",
      "type": "prompted",
      "prompted": {
        "base_voice": "Puck",
        "input": "Keep the existing accent and friendly character. Make the voice slightly lower and more measured."
      }
    }
  }' \
  --output remixed-voice.json
base_voice 可以是预置声音名、扩展声音库 ID,或当前项目拥有的已保存 prompted voice。store 对这种声音必须为 true。响应包含新 ID 和 sample_audio,后者是 24kHz WAV 预览的 Base64 数据;JSON 文件本身不是可直接播放的 WAV。
后续合成时,在原生 Interactions 请求的 generation_config.speech_config 中引用新 ID;需要临时表演时,在输入文字的 speech_metadata.style 中设置。具体多媒体请求结构以官方合成示例为准。若文件无法播放,先检查响应类型、Base64 解码和文件是否完整;可借用生成结果保存与校验的方法,但不要套用图片文件签名。
一次只改一两项,保留同一段试听稿
先选与目标语言和口音接近的基础声音,再尝试“降低一点音高”“更沉稳”这样的相对变化。官方建议每轮只改一两项,并先听预览再继续。它也说明,未明确要求时会保留基础语言和地区口音;这仍是能力说明,不是每次输出都符合预期的证明。
试听应复用同一段文字。比如准备三类句子:一个正常解释、一段包含日期和数字的说明、一句包含产品名的短句。逐项听是否漏字、重音是否合适、专有名词是否正确,再看声线变化。下面只是可替换的公开试音文字:
下一节介绍怎样整理会议资料,请先保留原始录音。
演示会议定在十一月十二日,上午九点三十分开始。
产品名称需要按词表确认,不要为听起来流畅而改写。
把候选 A、B 与原声放在相同文本和相近播放条件下比较。没听过的中文或方言,不因文档列出语言支持就写成“自然”“稳定”或“接近真人”。
声音 ID 也有范围与到期时间
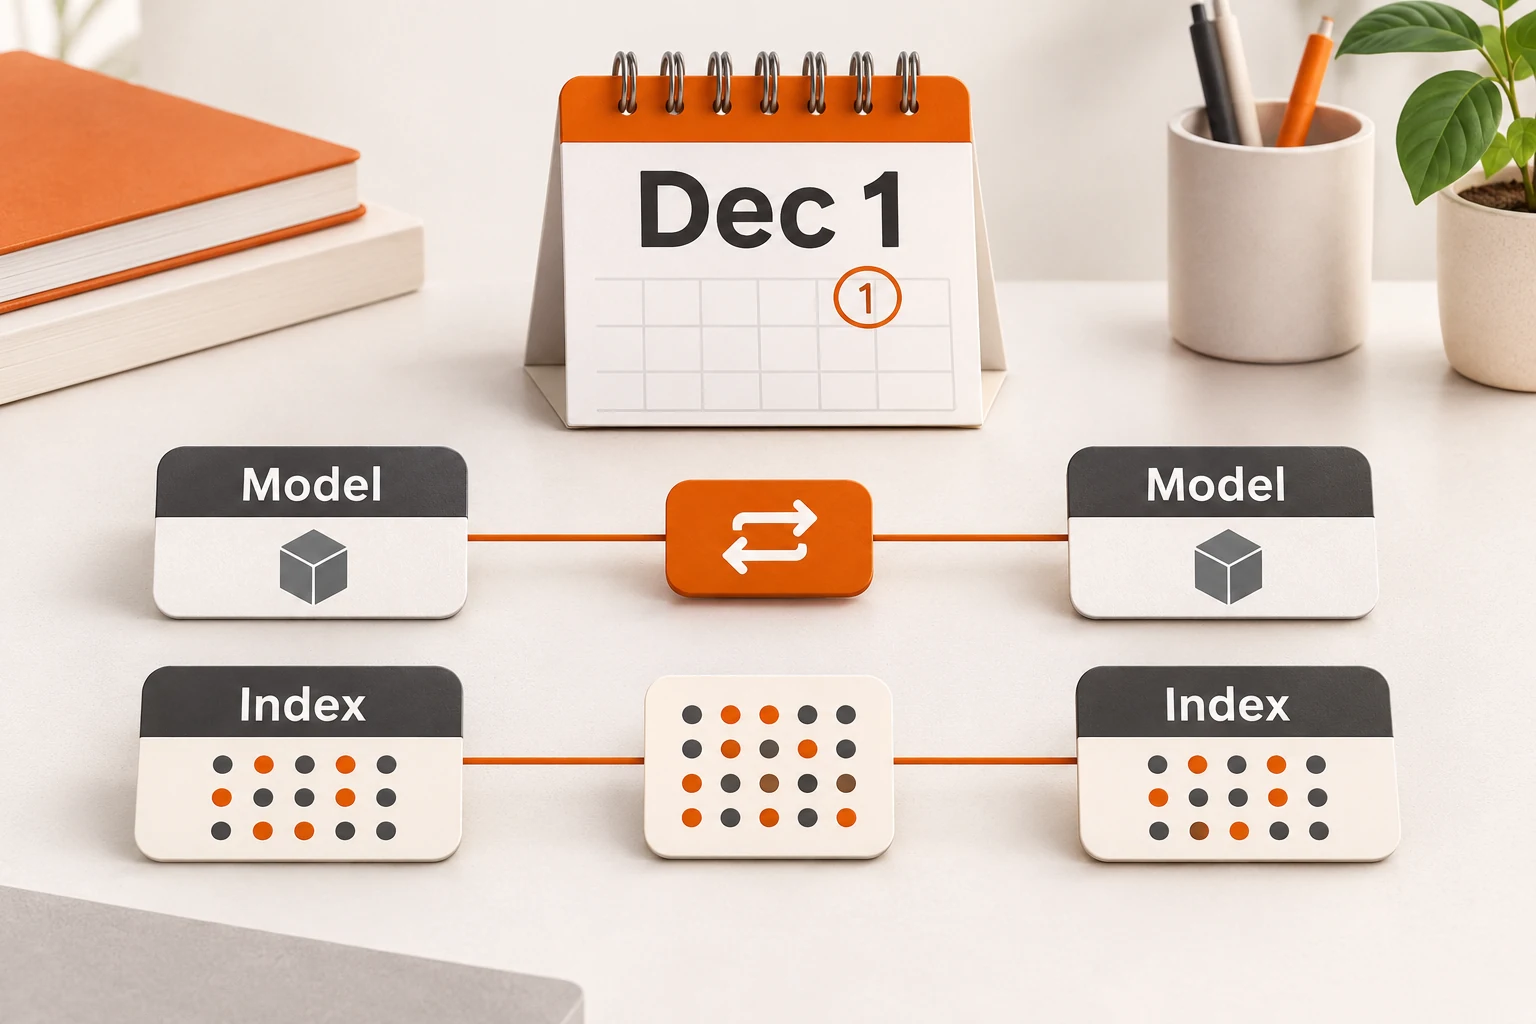
当前官方条件是付费项目 Tier 1 或以上;每项目最多 200 把 stateful voices,由设计、Remix 和已保存的复制声音共用。保存不是永久承诺:有效期为最后使用后一年,合成或作为下一轮 base_voice 使用会刷新到期窗口,具体时间看 expire_time。
建议为可用声线保留名称、项目、父 ID、修改描述、试音稿版本和到期时间。新声线独立于原声线,删除原声线不会连带删除它;清理候选时要按各自 ID 管理。跨项目或服务使用不能默认 ID 通用。
通过 Nbility 做配音时,先查音频接口文档和模型目录,分别确认合成模型、可用声音与格式。本站的通用 TTS 接口并未在这里被验证为支持 Google 的声音创建与存储资源。把声线选择、合成入口和资源维护分别确认,才方便把一次满意的配音延续到下一期内容。