群机器人记住了谁的话,应该由会话边界决定
从群聊、私聊和跨会话偏好拆解机器人记忆,用公开身份样例检查缓存、摘要、知识检索和后台任务,避免只靠提示词阻止历史串群。
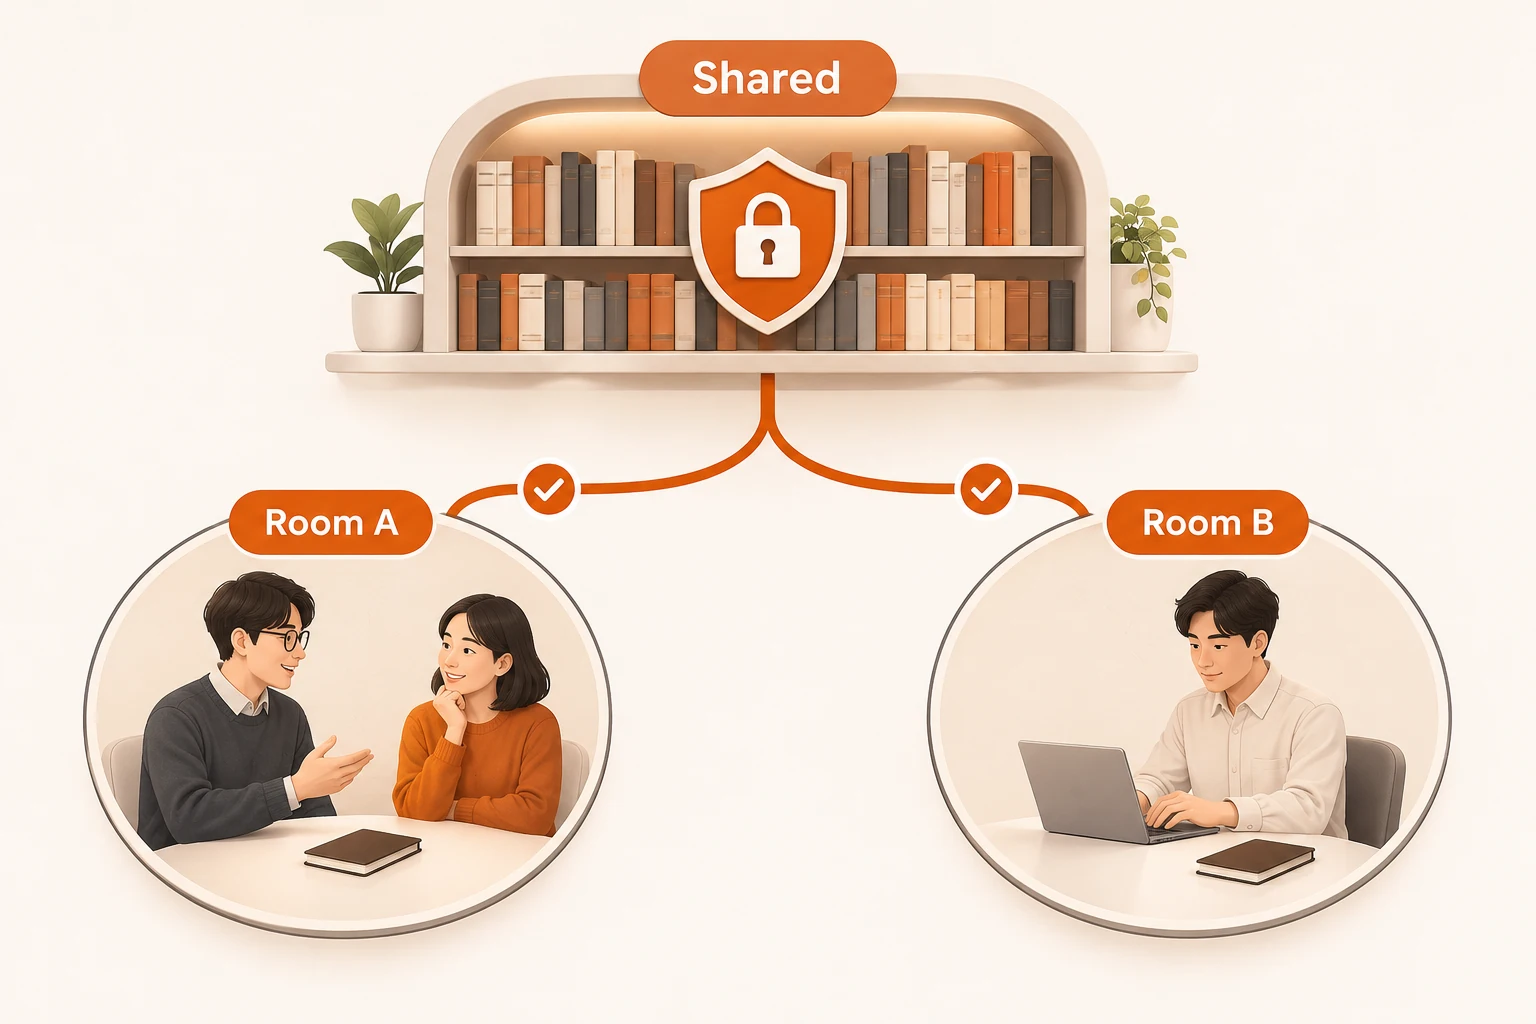
同一个机器人进了两个群,A 群刚讨论完内部报价,B 群有人问“刚才说的价格是多少”。正确的处理方式应由应用的数据范围决定:B 群这次请求不应带上 A 群的对话、摘要或检索结果。 在提示词里写“不要泄露其他群的信息”,补不了读取阶段已经混入的数据。
本文于 2026 年 11 月 13 日查阅 LangGraph 当前记忆与持久化说明。讨论的是应用设计,不是飞书、Telegram 或某款客户端已确认存在的漏洞。文中身份和消息均为公开教学数据;没有连接真实群,也没有运行完整机器人。
先确定什么算同一段对话
“给每个用户存一份历史”不一定适合群聊。同一个人可能在公司群、外部客户群和私聊中与机器人交谈,这三处内容不应因为发送者相同就自动合并。
反过来,若目标是群内连续讨论,只按发送者分开,又会让机器人看不到同群其他人已经说明的条件。应该先确定产品语义,再选择会话标识。
| 使用方式 | 历史通常按什么划分 | 需要额外决定什么 |
|---|---|---|
| 群内所有人共同讨论 | 租户、平台、群、话题 | 是否允许整群读取全部相关历史 |
| 群内个人助手 | 上述范围再加用户 | 回复会不会被其他群成员看见 |
| 私聊 | 租户、平台、私聊身份、用户 | 是否复用跨会话偏好 |
| 客服工单 | 租户、工单、参与范围 | 转交后谁还能读历史 |
飞书机器人接入文章解决基础链路。本篇补的是消息进入历史前的范围设计;具体平台是否有独立话题 ID,要查实际事件结构,不能假定字段都一样。
会话 ID 只是索引,不是访问许可
LangGraph 当前文档将 checkpointer 的状态限定在一个 thread,通过 thread_id 找回;store 则能保存跨 thread 的长期信息。这个区分很有用,但框架不会从一个字符串自动推断企业权限。
下面是应用设计用的 JSON 示意,不是某个平台的事件协议,也不是可直接复制的完整鉴权实现:
{
  "tenant_id": "demo-company",
  "platform": "demo-chat",
  "conversation_kind": "group",
  "conversation_id": "demo-room-a",
  "topic_id": "demo-topic-1",
  "memory_scope": "group-shared"
}
服务端应从验证过的事件或登录上下文取得这些值,检查当前主体能否访问,再生成内部会话 ID。不要允许请求正文随意填写另一个群的 ID 并读取历史。ID 可以是结构化元组的稳定编码或内部映射,避免用未经转义的字符串拼接造成碰撞。
即使每个用户有独立 API Key,应用仍可能误用同一个历史键。企业空间里的成员、密钥和用量范围,不能替代机器人自己的会话访问控制。
摘要、检索和缓存也要跟着分开
常见遗漏是只给消息表加上群 ID,其他记录仍用全局键:
- 压缩摘要写进一个固定的
summary,新请求又把它加回来; - 回复缓存只看问题文本,忽略租户、权限与文档版本;
- 长期偏好只按显示名保存,重名用户拿到同一条记录;
- 后台总结任务沿用上一次循环的群标识,结果发到了另一处。
跨会话记忆可以保留,但需要明确授权范围。例如“回答用简体中文”可以属于一个用户的偏好;一份项目报价则可能只属于某个项目组。语义相近不是访问许可,向量搜索前后的过滤都要由应用保证,不能让模型自行决定能读谁的记录。
MCP 工具权限同样强调:工具返回内容不能扩大原有授权。机器人调用搜索、CRM 或文件工具时,会话范围也必须一路传递。
用不会暴露信息的素材检查
在临时环境准备两个群和两个用户,为 A 群写一句容易识别的教学事实:“演示代号是橙桥。”然后分别检查:
- A 群续问能否找到自己的前文;B 群同样续问时,输入中不出现这句内容。
- 同一个人在 B 群或私聊提问,是否仍按设计隔离;群内第二个人能否按产品约定参与共同讨论。
- 执行一次摘要后重查;开启回复缓存、知识检索和后台总结后也分别重查。
- 换成不存在或无权访问的会话标识,服务端应拒绝,而不是建立指向其他历史的读取路径。
成功迹象应包含发送给模型前的脱敏范围记录和实际选中的片段;仅凭模型回答“我不知道”,不能证明它没有收到不该收到的内容。记录方式见求助日志脱敏。
最后再测“清空记忆”。如果只删当前消息,旧摘要、检查点或长期 store 仍可能保留相关信息。按存储清单定义清除范围和保留规则,不把界面上的一个按钮等同于所有副本已经删除。把这些边界定清楚,机器人才能在需要记住时接得上,在不该共享时读不到。