流式配音收到了字节,播放器为什么还没声音
区分 TTS 的网络分块、音频编码与播放器缓冲,检查 MP3、PCM、采样率和完整下载,用可计算的小例子解释音频已返回却无法播放。
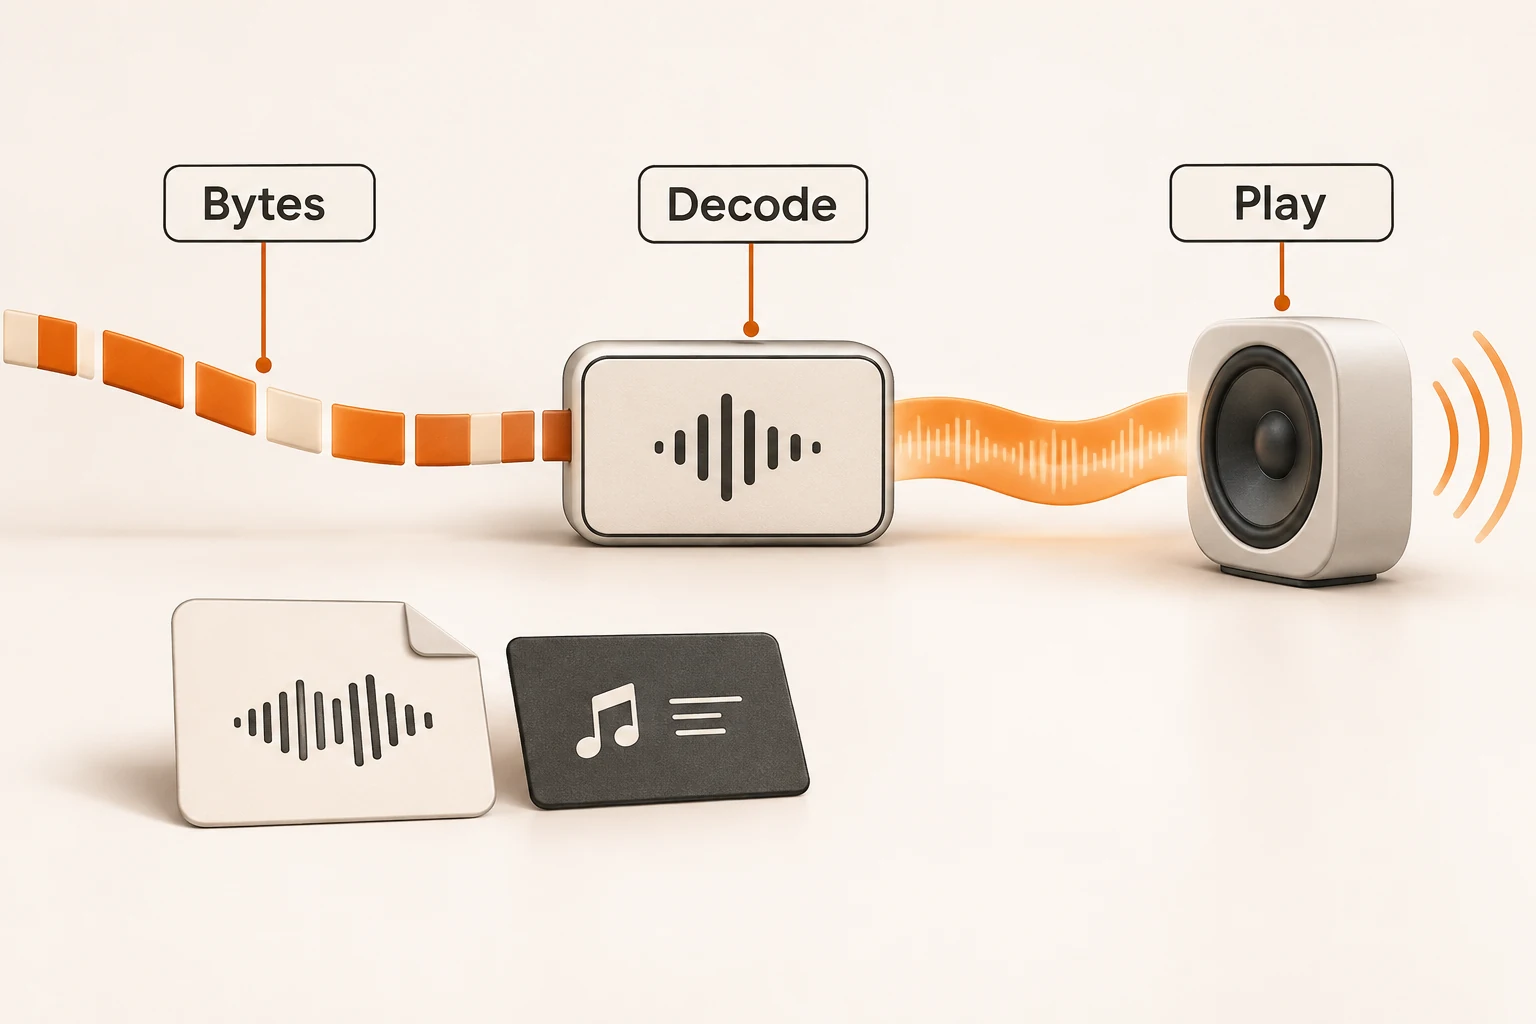
配音接口已经返回数据,前端也持续收到字节,播放器却没声音。先确认这三个问题:返回的是音频还是错误内容,字节采用什么编码,播放器是否按同一格式持续解码。 收到一个网络分块,不等于已经得到一段能独立播放的声音。
本文于 2026 年 11 月 13 日读取 ElevenLabs 当前流式 TTS 文档、MDN Streams 与 AudioBuffer 说明,并对照本站音频 API。讨论通用接入关系;没有请求真实配音、做浏览器播放测试或测量延迟。不同供应商和兼容渠道的流式形式需各自确认。
网络分块和音频帧各有边界
MDN 的可读流说明用 reader.read() 逐块读取响应。这里的块取决于传输与缓冲,不能当成一句话、一帧音频或完整文件。
例如,一个压缩音频帧可能跨两个网络块。若应用收到一块就新建播放器或重新启动解码器,可能丢掉解码所需的前文,也可能出现间断。这和SSE 的事件边界有相近的传输问题,但音频响应不一定是 SSE,更不能默认用文本事件解析器处理二进制音频。
先读具体端点说明。有的返回二进制流,有的通过结构化事件带音频数据,还有的先返回任务结果再下载文件。名称里有“stream”,不足以判断字节该怎么交给播放器。
扩展名改成 MP3,不会改变内容
ElevenLabs 的流式端点当前使用 output_format,默认示例为 mp3_44100_128;本站通用 TTS 文档使用 response_format,如 mp3、wav,具体支持由模型决定。这两套字段和枚举不应互换。
若响应是裸 PCM,它是按约定排列的采样数据,通常需要另外知道采样率、声道数、位深、整数或浮点、字节序。把文件命名为 .wav,不会自动补上 WAV 容器头;把它命名为 .mp3,也不会进行 MP3 编码。
AudioBuffer表示内存中的解码后音频,数据按声道保存为浮点采样;不能把任意压缩文件字节直接当作这些采样值。实际方案可以使用支持该编码的持续解码链路、合适的媒体播放接口,或先完成下载后再解码,取决于目标浏览器和输出格式。
用一秒 PCM 把单位核对清楚
下面只做离线算术:假设供应商明确返回 24,000 Hz、单声道、有符号 16 位 PCM,每个采样占 2 字节,那么一秒有效采样数据应有:
24,000 个采样/秒 × 1 声道 × 2 字节/采样
= 48,000 字节/秒
若把同一批采样按 48,000 Hz 播放,时长会变为原来的一半,音调也随之变化。这解释了为什么“声音快了一倍”可能是采样率设置问题。这个数字仅适用于给定 PCM 条件,不适用于有压缩的 MP3,也不是任何模型的固定输出格式。
流式处理 16 位 PCM 时,还要保留不足一个完整采样的尾部字节,和下一块一起处理;多声道则按完整音频帧对齐。不能因为一次读取拿到了奇数字节,就静默丢掉最后一字节。
先拿到一个完整文件,再拆播放链路
若想确认 Nbility 的基础 TTS 路径,先用自己的可用模型和声音请求完整 MP3。以下命令未进行真实调用,不证明所选模型支持流式播放:
curl --fail-with-body --show-error   https://api.nbility.ai/v1/audio/speech   -H "Authorization: Bearer $NBILITY_API_KEY"   -H "Content-Type: application/json"   --dump-header speech.headers   -d '{
    "model": "YOUR_TTS_MODEL",
    "voice": "YOUR_VOICE",
    "input": "这是一段公开的配音检查文本。",
    "response_format": "mp3"
  }'   --output speech.mp3
检查退出码、状态与 Content-Type,再看文件是否能被音频工具完整解码。--fail-with-body 遇到 HTTP 错误会返回失败,但仍可能把错误正文写入输出文件;不能因为存在 speech.mp3 就认定它是音频。speech.headers 也应只在本地保存,分享前检查敏感字段。
完整文件可播放、流式界面却无声时,再查连续解码、缓冲队列、播放调度和浏览器自动播放策略。需要用户手势启动的播放不要自动当成 API 故障。若文件本身无法解码,则先查响应内容、格式和下载是否完整;保存失败的恢复方法可参考图片下载文章中“生成与交付分开”的思路,但音频必须使用自己的解码验证。
评价体验时,分别记录首个响应字节、首段可解码音频和真正开始播放的时刻。它们回答不同问题,不能把接口首包时间直接写成用户听到声音的时间。需要可复用角色声线时,再看声音 Remix 与存储;声线管理与流式播放仍是两项独立工作。