长音频分段转写后时间戳从零开始:怎样还原整场会议
用 FFmpeg 导出分段清单,记录每段实际起点,再把局部转写时间换回全局时间。说明重叠文本、说话人标签和模型格式支持的边界。
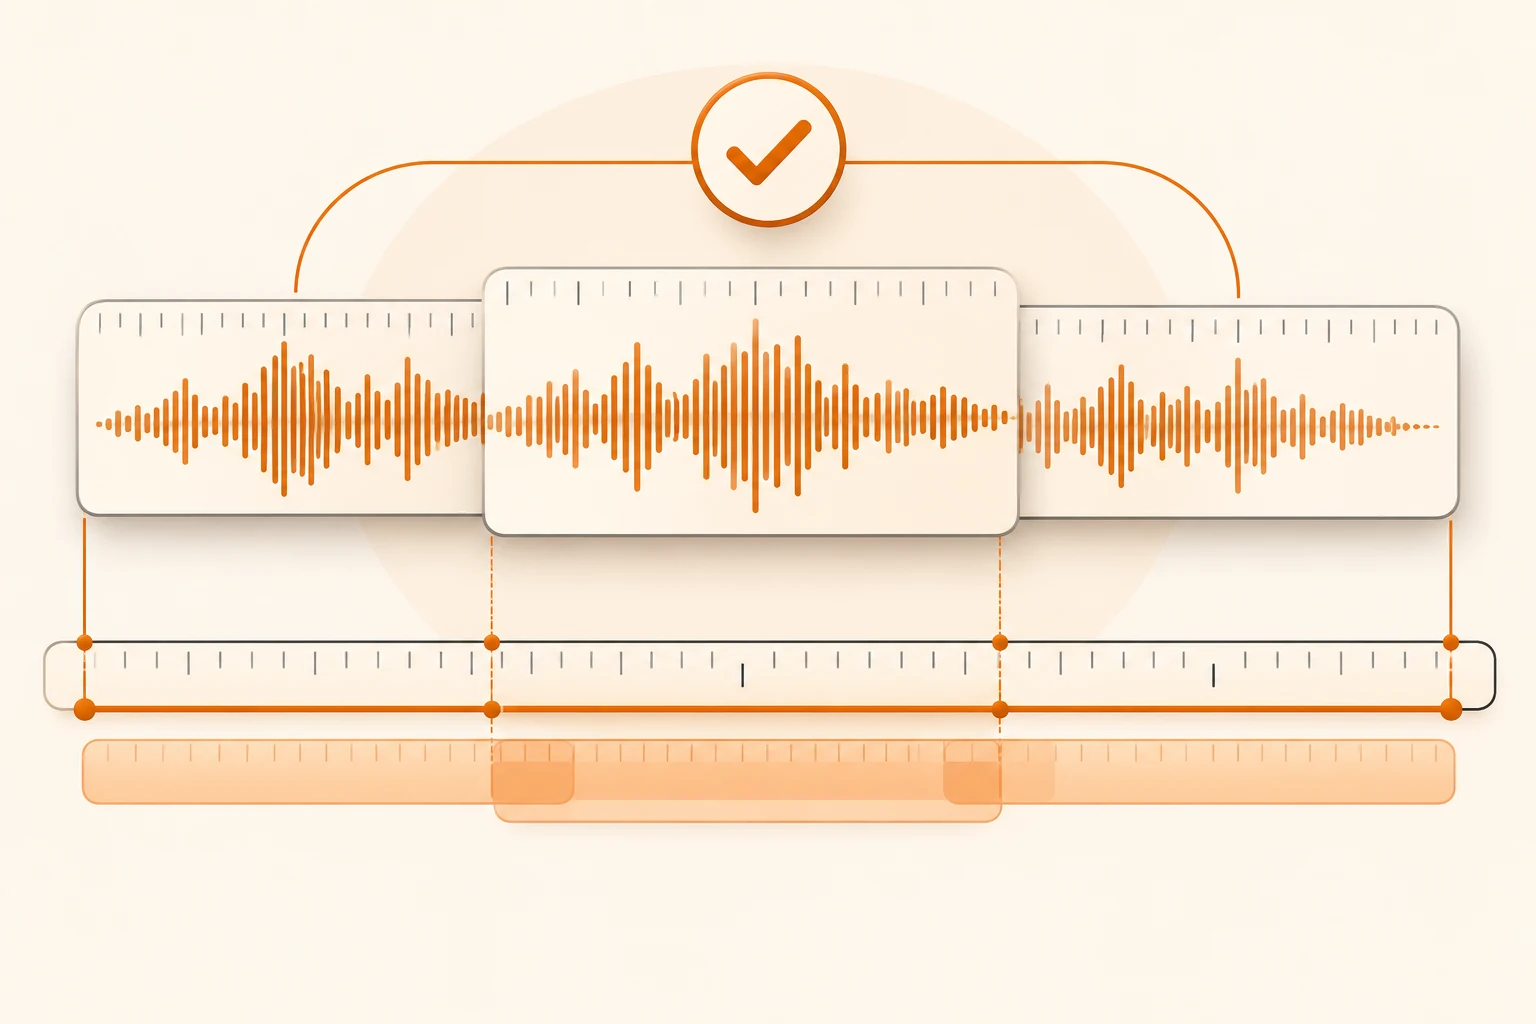
一小时录音拆成几段,转写结果里的时间又从 00:00 开始,直接拼接字幕就会重叠。解决时要保留两条时间线:每段在原音频里的实际起点,以及转写结果在该段内部的时间。 合并时把它们相加,再检查边界重复和断句。
本文于 2026 年 11 月 10 日查阅 FFmpeg 项目文档和本站音频接口说明。下文分段命令已在 FFmpeg 9.0.2 上用合成静音运行;没有上传真实录音、调用转写模型或验证说话人识别效果。
切之前先保留原文件与目标要求
先确认所选转写模型支持的文件类型、大小、时长、语言和输出格式。不要从某个供应商的限制推导所有兼容接口都相同。需要时间戳时,先用很短的公开录音确认它确实返回段级或词级时间;只有纯文本,就不能靠加一个提示词得到可靠的音频定位。
保留原文件的只读副本,记录你做过的转码、裁剪和采样设置。降为单声道可能影响依赖声道分离的处理;下面的 16 kHz 单声道 WAV 只是一种演示输出,不是所有模型的强制要求,也不用于证明音质最优。
切片时同时导出清单
在新的工作目录执行,输入文件名换成自己的本地副本。已有输出时先检查,不要直接覆盖:
mkdir -p chunks
ffmpeg -i meeting.wav \
  -map 0:a:0 -vn -ar 16000 -ac 1 -c:a pcm_s16le \
  -f segment -segment_time 600 \
  -segment_list chunks/segments.csv -segment_list_type csv \
  -reset_timestamps 1 chunks/chunk-%03d.wav
这里 600 是演示切片长度,不是 API 上限。按目标模型要求修改,并留出余量。输出 PCM WAV 可能比压缩输入大很多,切了时长也不保证满足上传大小限制。
FFmpeg 的 segment 文档源码定义了 CSV 清单的三列:文件名、片段起点秒数、片段终点秒数;没有表头。reset_timestamps 尝试让每段从接近零的时间开始,它与清单里原时间线上的起点用途不同。
本地合成 1250 秒静音的结果为:
chunk-000.wav,0.000000,600.000000
chunk-001.wav,600.000000,1200.000000
chunk-002.wav,1200.000000,1250.000000
这是命令与容器边界验证,不是语音识别结果。其他编解码器和切分方式可能受包或帧边界影响,应读实际清单和媒体信息,不要永远用“第几段 × 600”推测起点。
先验证一小段,再提交长任务
本站音频接口说明转写使用 multipart 请求。下例仅展示基本请求,模型 ID 用实际可用值替换:
curl --fail-with-body --silent --show-error \
  https://api.nbility.ai/v1/audio/transcriptions \
  -H "Authorization: Bearer $NBILITY_API_KEY" \
  -F "model=YOUR_TRANSCRIPTION_MODEL" \
  -F "file=@chunks/chunk-000.wav" \
  -F "response_format=json" \
  --output chunk-000.transcript.json
这个基本 JSON 格式不保证包含时间戳。若任务需要时间戳,先按模型文档选择支持的返回格式和参数,并检查实际响应。不要把各家字段猜成统一格式,也不要把接口错误保存成 .json 后继续当转写结果合并。本文没有执行这条带认证请求。
模型权限先按模型列表检查核对。上传失败时先查看状态、响应类型和文件大小,不要把同一段无限重提。
把局部时间换回全局时间
计算规则是:
原音频开始时间 = 清单里的片段起点 + 该段转写开始时间
原音频结束时间 = 清单里的片段起点 + 该段转写结束时间
例如,片段实际从 600.000 秒开始,一句话在该段的 12.400–15.800 秒,回到原音频就是 612.400–615.800 秒。这是算术示例,不是模型输出。若音频前面裁掉了 30 秒,而目标是未裁剪的原录音时间,还要加上那 30 秒。
合并前检查时间是有限数字、开始不晚于结束、没有明显超出对应片段;保留必要的编码误差容差,但不要静默把离谱值改成“合理”字幕。按全局开始时间排序,并保留源片段名,便于回听。
重叠与说话人标签要另行处理
上面的命令按连续区间切分,没有主动添加重叠。若为了保住跨边界句子而另做重叠切片,应记录每段真实起点,而不是按固定编号相加。重叠区两次识别可能措辞不同,不能只删完全相同的字符串;根据时间和原音频核对后保留一次。
每段的 speaker_0 也不必然是整场同一个人。需要全局说话人身份时,要有支持这项能力的流程,并单独验证,不按编号机械合并。数字、姓名和会议决定还应回听确认,转写文本不是自动通过的会议纪要。
最终验收听三处:开头、切片边界和结尾,再抽查实际引用的时间点。只需要摘要时,可在校对后的转写基础上参考文档总结方法;仍保留音频时间引用。使用 Nbility 时,按接入基础配置专用凭据,原录音与转写涉及个人信息时,控制存储副本、访问权限和保留时间。