Mistral Large 4 取消 none 档后,推理参数该怎么迁移
Mistral Large 4 只接受 low、medium、high,省略 reasoning_effort 默认 high;迁移 none 时还要检查 thinking 块、流式内容和历史回传。
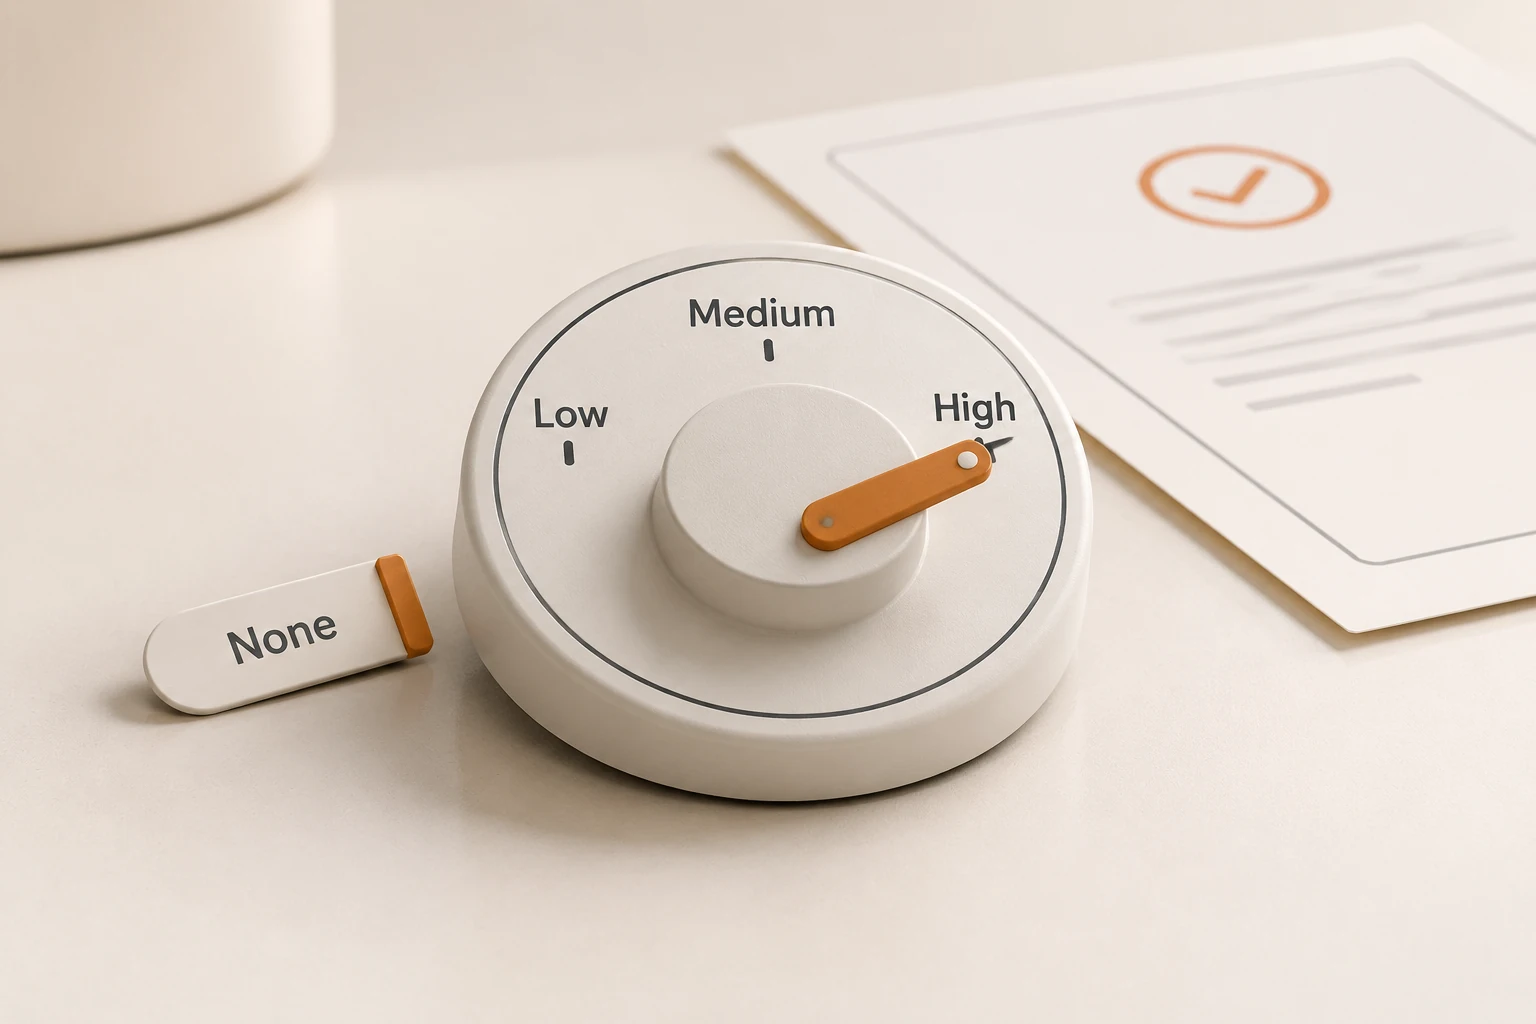
Mistral Large 4 现在只接受 low、medium、high 三档 reasoning_effort,旧的 none 会返回 400。省略字段会使用 high;想减少推理应明确选择 low,但它仍然会推理并返回 thinking 内容。 不能把别家模型的档位表整份复制过来。
本文于 2026 年 11 月 18 日复查Mistral 更新记录与当前推理指南。更新记录把这项参数变化列在 10 月 29 日,不是今天刚发生。本文提供请求与解析迁移方法,没有发起 Mistral API 请求,也没有测量不同档位的速度或质量。
为什么 SDK 允许的值,模型却拒绝?
SDK 的枚举常为多个模型共用,列出一个值不代表所有模型都接受。当前官方表格中,Mistral Large 4 与另外两类模型的合法范围不同:
| 官方文档中的模型 | 支持的档位 | 容易误用的地方 |
|---|---|---|
mistral-large-4 / mistral-large-4-0 | low、medium、high | 不支持 none、minimal、xhigh、max |
mistral-small-2603、mistral-medium-3-5 | 文档说明 none 与 high | 不能把这一组推广到 Large 4 |
Mistral 平台上的 zai-glm-5-3、zai-glm-5-3-flash | low、high、max | max 不是 Large 4 的合法别名 |
这里写的是 Mistral 官方平台的文档行为。自部署引擎、其他托管服务或网关可能有自己的参数映射,不能只因模型名称相近就认为完全相同。模型列表与实际能力解释了为什么能列出模型还不足以验证调用。
从 Preview 的 none 迁移,应该改哪一行?
如果原请求明确写了 "reasoning_effort": "none",先判断业务意图。想要最少推理,就改为 low;如果希望按复杂任务的官方建议起步,可以显式设 high。删除字段会回到默认 high,不会保留以前的 none 行为。
- "reasoning_effort": "none"
+ "reasoning_effort": "low"
low 仍会产生推理 token、返回 thinking chunk。官方提示,与旧 none 相比应预期更多输出 token 和延迟,但没有给出适用于所有任务的固定增幅。不要用“关闭推理”标注这个选项。
下面是向 Mistral 官方 Chat Completions 发出的最小请求示例,未在本文运行。Key 从自己的环境取得:
curl --fail-with-body https://api.mistral.ai/v1/chat/completions \
  -H "Authorization: Bearer $MISTRAL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistral-large-4-0",
    "messages": [{"role": "user", "content": "Calculate 17 * 23."}],
    "reasoning_effort": "low"
  }'
如果客户端只提供“关/开”两个选项,要先查它实际发了什么,再调整模型配置;不能只改下拉框文字,让“关”背后仍发送 none。OpenCode 的版本与 Variant 配置可结合推理档位设置说明核对。
返回的 content 还能直接当字符串吗?
不能一直这样假定。当前推理指南说明,带 thinking 的响应内容由块组成,最终文本在 type: "text" 的块中,推理内容在 type: "thinking" 块中。显示答案和保存历史要分开处理。
下面的 Python 片段处理已经解析成字典的非流式官方响应,这里只提取用户要看的答案。它不是跨供应商通用解析器,也没有处理工具调用、错误或空 choices:
message = response_body["choices"][0]["message"]
content = message.get("content")

if isinstance(content, str):
    answer = content
else:
    answer = "".join(
        block.get("text", "")
        for block in (content or [])
        if block.get("type") == "text"
    )

print(answer)
# Save the full message for later turns, not only answer.
这个片段已用本地合成字典验证字符串与 thinking/text 混合输入,没有运行官方 SDK。多轮历史按官方指南保留完整 assistant message,包括 thinking;只为界面提取答案,不能顺手把历史也缩成答案字符串。对于跨模型对话,还要另查目标模型是否接受原模型的块,不能从 Mistral 的回传建议推导其他协议。
流式输出再多一层变化:文档示例里,思考阶段的 delta.content 是块列表,转折处可能同一列表同时包含 thinking 与 text,答案阶段又可能是字符串。不能用一次类型判断锁定整条流。类似“返回 200 却没正文”的问题,也可参考空内容与推理字段检查。
怎样验证迁移没有把回答或历史弄丢?
先用一个无副作用、能算出结果的短任务检查链路,再试实际任务。不把一条算术题当质量排名。
建议至少记录四项:实际发送的模型与档位、非流式最终答案、流式是否完整收到答案、多轮续接是否保留完整消息。若这些通过,再用相同材料比较 low、medium、high 的完成情况、等待与用量;没有这样的记录,就不报告“省多少”或哪档永远最好。固定任务的方法可以帮助控制比较条件。
经过 Nbility 时,还要确认所选渠道怎样映射参数与响应,本文没有验证它与 Mistral 直连相同。关于权重、推理引擎和托管接口为何要分别核对,可继续读Le Chonk 的部署边界。先修正不合法参数,再检查解析与历史,比通过无限重试掩盖 400 更容易定位。