DeepSeek API 现在能直接读文件和网页吗?先分清上传、解析和读链接
deepseek-flash 从 11 月 13 日起支持文件输入和阅读链接。上传时选哪种解析方式、file_id 怎么在三种协议里引用、多轮为什么反复计输入,以及什么时候该自己解析。
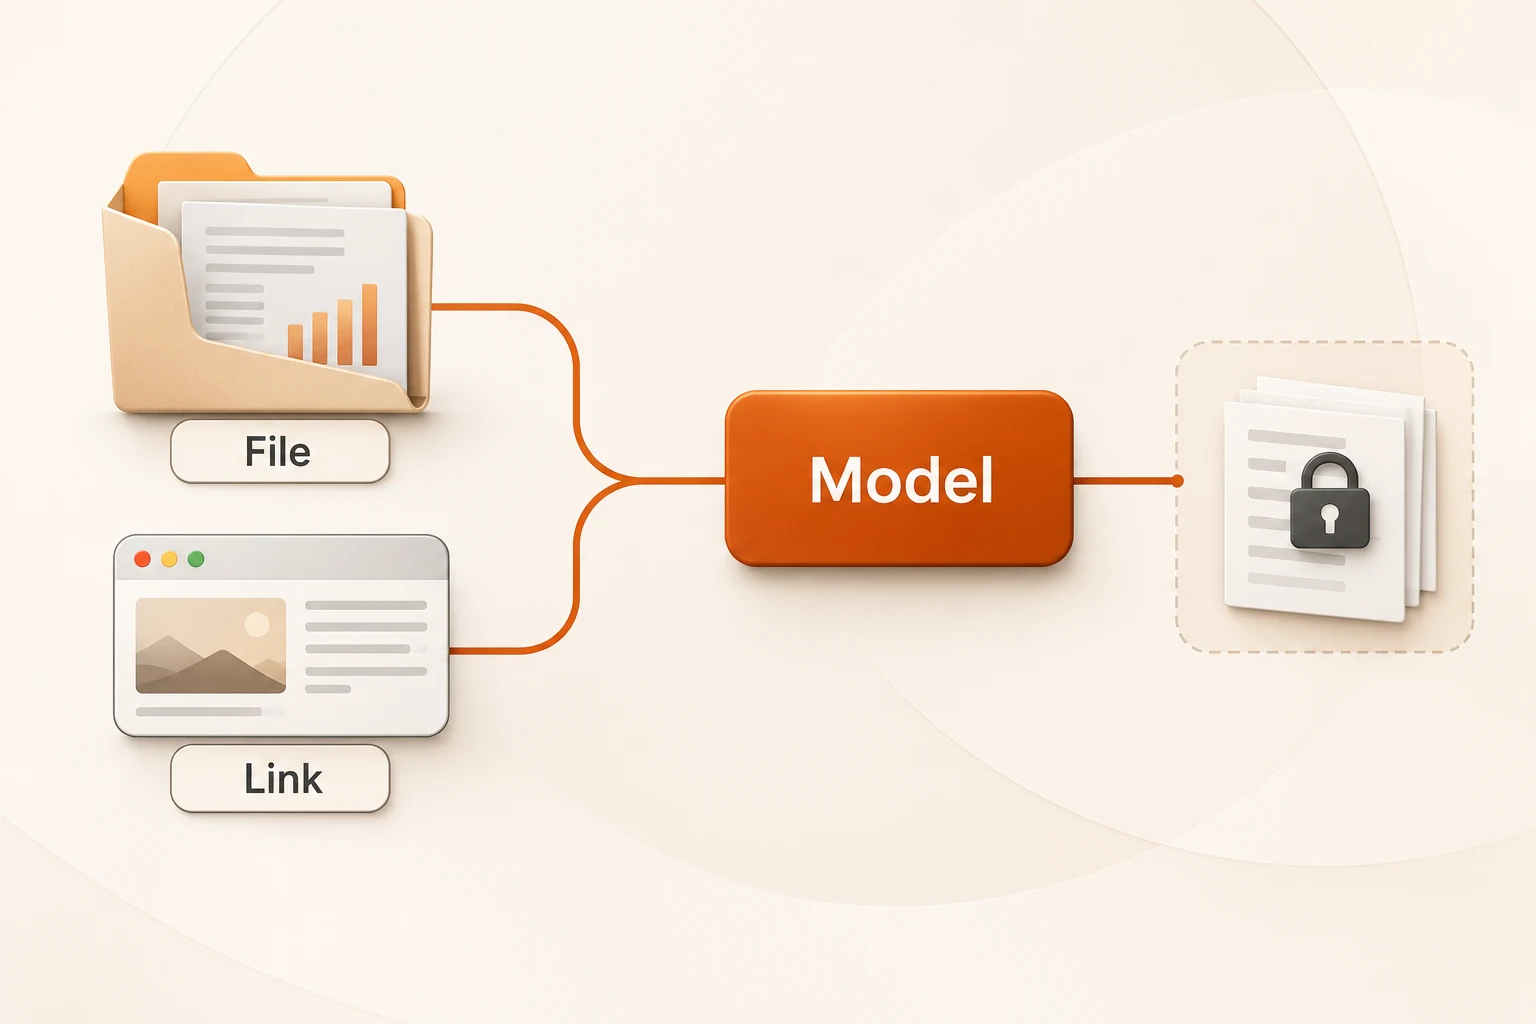
能。deepseek-flash 从 2026 年 11 月 13 日起支持两种方式把外部内容带进对话:把 PDF、Office 文件或图片传到 Files API 拿到 file_id 再引用;或者打开 deepseek_read_url 工具,让模型自己读用户消息里的链接。两者都由服务端完成解析和抓取,你只提交请求、接收结果。
但“支持文件”不等于“把文件塞进 messages 就行”。文档需要先上传、解析成功,才有 file_id;引用之后的内容会留在上下文里,每一轮都按输入 Token 计费。这篇文章按这三步讲清楚。
文件不是一个字段,而是三步
| 步骤 | 做什么 | 失败会怎样 |
|---|---|---|
| 上传 | POST /files,用表单字段带上 purpose 和文件 | 上传超过 120 秒返回 408,文件超过 100 MiB 返回 413 |
| 解析 | 上传时同步完成,服务端按 purpose 处理 | 超过 120 秒返回 504,解析不完整返回 500 |
| 引用 | 在对话请求里引用返回的 file_id | 超量、格式不对返回 400 |
关键一点:响应只在解析成功后才返回,期间服务端不发送任何数据。所以客户端、反向代理、网关的超时要按“上传时间 + 解析时间”设置,不能沿用普通的 30 秒。
另一个容易误判的地方:客户端断开不会取消解析。解析成功的话,文件照常保存、照常计费,之后能在 GET /files 里看到。遇到超时先别重传,先查列表。
两种解析方式:要不要让模型看到图
purpose 决定模型拿到什么,直接影响回答质量,也影响费用。
purpose | 模型得到 | 适合的文档 |
|---|---|---|
text_recognition | 只有文字,图表、照片、示意图被丢弃 | 合同、论文、扫描的文字材料 |
rich_layout_recognition | 文字,加上按原位置裁出的图 | 带图表的报告、幻灯片、带示意图的说明书 |
举个例子:一份财报里有一张营收趋势图,用户问“这张图说明了什么”。用 text_recognition,模型只读到正文,只能根据文字回答;用 rich_layout_recognition,模型能看到图,结合正文一起答。
两点限制要记住:
- 图是解析时自动识别并裁出的,不保证每张都被裁出。没被裁出的图,模型仍然看不到。
- 裁出的图会占用输入 Token,并计入每个请求的图片数量上限。模型不需要看图时,用
text_recognition更省。
还有第三种 purpose:user_data。它对应不需要解析的文件——图片、txt/md/csv/json 和源码,以及 XLSX/XLS 表格、EPUB/MOBI 电子书(上传时转成 Markdown,AZW3 和带 DRM 的电子书不支持)。这类上传不计解析费,原始文件最大 32 MiB、文字最大 8 MiB。文档没有说明转换后表格的公式、多工作表和图表会保留到什么程度,用表格做数据问答前,最好先用一份已知答案的小文件试一次。
三种协议怎么引用同一个 file_id
文件属于账号,同一账号下的所有 API Key 都能引用。三种协议只是 block 的形状不同:
Messages(https://api.deepseek.com/anthropic/v1/messages)需要一个 beta 头:
{
  "model": "deepseek-flash",
  "messages": [{
    "role": "user",
    "content": [
      {"type": "document", "source": {"type": "file", "file_id": "file-api-xxxxxxxxxxxxxxxx"}},
      {"type": "text", "text": "总结这份文档的要点。"}
    ]
  }]
}
请求头要加 anthropic-beta: files-api-2025-04-14。这里很容易踩坑:用 curl 时路径要写全 /anthropic/v1/messages,而 Anthropic SDK 会自动补 /v1。
Responses 用 input_file,Chat Completions 用 file,两者都不需要额外请求头:
{"type": "input_file", "file_id": "file-api-xxxxxxxxxxxxxxxx"}
{"type": "file", "file_id": "file-api-xxxxxxxxxxxxxxxx"}
只用 file_id,不要传文件内容或 URL。 文档类文件不支持在请求里直接传 base64 或链接,必须走上传流程。文档也不能当作图片引用,放进去返回 400。
反复计费发生在引用,不在上传
费用分两处:
| 环节 | 计费方式 | 当前价格 |
|---|---|---|
| 上传解析 | 按页,解析成功才计 | 每 1,000 页 1.5 元 |
| 对话引用 | 按输入 Token,等于文档解析结果拼进上下文 | deepseek-flash 输入价,高峰每百万 Token 2 元、空闲时段 1 元 |
所以一份 150 页的报告,解析费约 0.225 元,这在整笔支出里通常很小。真正占大头的是引用:文档内容会完整留在对话上下文中,每一轮都作为输入重新计费,而且不会静默截断,超过上下文上限直接返回 400。
假设这份报告解析后是 30 万 Token,你问 8 轮:
- 如果不命中缓存,单看这份文档就是 30 万 × 8 = 240 万输入 Token,高峰时段约 4.8 元。
- 如果前缀命中缓存,缓存部分按每百万 0.04 元(高峰)计,金额会低一个数量级。
这也是为什么同一个文档在同一会话里反复引用,要确认缓存是否生效。相关背景见T3 Code 用量与账单:看到的数字、API 等价估算和实际结算,本来就是三件事。
单请求还有两条硬限制:最多引用 20 个文档,文字合计 8 MiB。重复引用同一个 file_id 也分别计算,把同一份大文档在一条消息里塞三次,可能直接撞上限。
阅读链接:只处理最后一条用户消息
deepseek_read_url 的工作方式和你写一个抓网页的函数不一样:
- 只有最后一条用户消息里的链接会被检查,最多前 10 个不同的链接,重复的只算一次。模型自己决定读哪几个。
- 如果同时开了思考模式和
deepseek_web_search,这一轮走深度思考搜索,不单独读链接。想只读链接,就只声明deepseek_read_url。 - 每读一页,产生一个
server_tool_use(input.action为read_link)和一个web_fetch_tool_result块。多个链接会先全部调用,再一起返回结果。 - 结果里有 URL、标题、发布日期,但正文不在块里:页面内容加密放在
signature中。多轮对话时要原样传回这个块,否则页面不会恢复到上下文。
失败状态分三种,处理方式不同:
error_code | 含义 |
|---|---|
url_not_accessible | 链接读不到 |
url_not_allowed | 不允许读,或页面没过内容安全审核 |
unavailable | 服务不可用、页面打不开,或调用未完成 |
计费按成功抓取的页数算。对于被 url_not_allowed 和 unavailable 替换掉的结果,文档说明仍然计费——也就是说,审核拦下的页面你仍然要为抓取付钱(每 1,000 次 5 元)。所以不要拿它去批量扫不确定是否允许读取的站点。
什么时候该自己解析
服务端解析省掉了 OCR、切块、拼上下文的活,但不是所有场景都合适:
- 需要对原文定位:引用要精确到页码和段落时,自己解析并保存原文,才能事后核对。这一要求和PDF 问答的引用链一致。
- 同一份资料要给很多用户反复用:上传解析结果不能下载,没有可复用的中间产物。把它放进自己的知识库,再做检索,成本比每轮带全文更可控。
- 需要看多张表或保留格式:
user_data的表格转换只保留文本,图和多表结构会丢,自己转换格式更可靠。 - 文件本身不能外发:上传即离开你的系统,对方如何处理、保留多久,取决于服务条款和你的账号设置。敏感合同、客户数据应先在内部评估。
反过来,一次性问答、临时读一份外部文档、内部工具里的“把这篇文章总结一下”,直接用服务端能力最短。
另外,今年围绕文件输入的变化不少,Gemini 侧则是另一套规则(只看首表、PPT 转页面图像等),对照见把 Excel 和 PPT 交给 Gemini,它实际看到了什么。两者都提醒同一件事:上传成功不等于模型看到了你以为的内容。
FAQ
上传的文件能下载回来吗? 不能。原始文件和解析结果都不支持下载,自己的系统要保留原件。
文件会保存多久?
默认永久保存。上传时可以传 expires_after[anchor]=created_at 和 expires_after[seconds](1 小时到 30 天)设置过期。账号下最多存 10,000 个文件、共 25 GiB。
为什么上传报了 400,提示 purpose 相关?
文档类文件必须把 purpose 放在 file 字段前面发送。OpenAI Python SDK 默认先发表单字段,不用改;手写 curl 或自建 multipart 时要注意顺序。
同一账号换了 API Key,之前上传的文件还能用吗? 能。文件属于账号,同一账号下的 Key 共享,但只能在这个账号里引用。
通过 Nbility 使用时的现状
Nbility 目前没有 /files 这类文件上传接口,也没有把 deepseek_read_url 作为独立路由暴露出来。直接按官方文档上传文件,需要拿到 DeepSeek 的 API Key 并请求官方地址。
走 Nbility 时,先按接入基础确认可用模型和调用方式;把文件内容转成文本自己拼进 messages 的用法不受影响,但要自己承担解析和长度控制,参考AI API 返回空内容里的重试注意事项。需要模型联网找资料时,DeepSeek 的搜索与抓取能力是另一条路径,见DeepSeek 搜索 API 开放后,研究简报可以把找、读、引用拆开。