用 DeepSeek 新接口做对外聊天机器人,拒答要在前端处理
DeepSeek 11 月 13 日开放联网搜索、文件输入、阅读链接和模型安全参数。对外提供服务时,流式回答可能在结束后被判拒答;本文说明三种协议的拒答标记、计费与文件解析的超时设置。
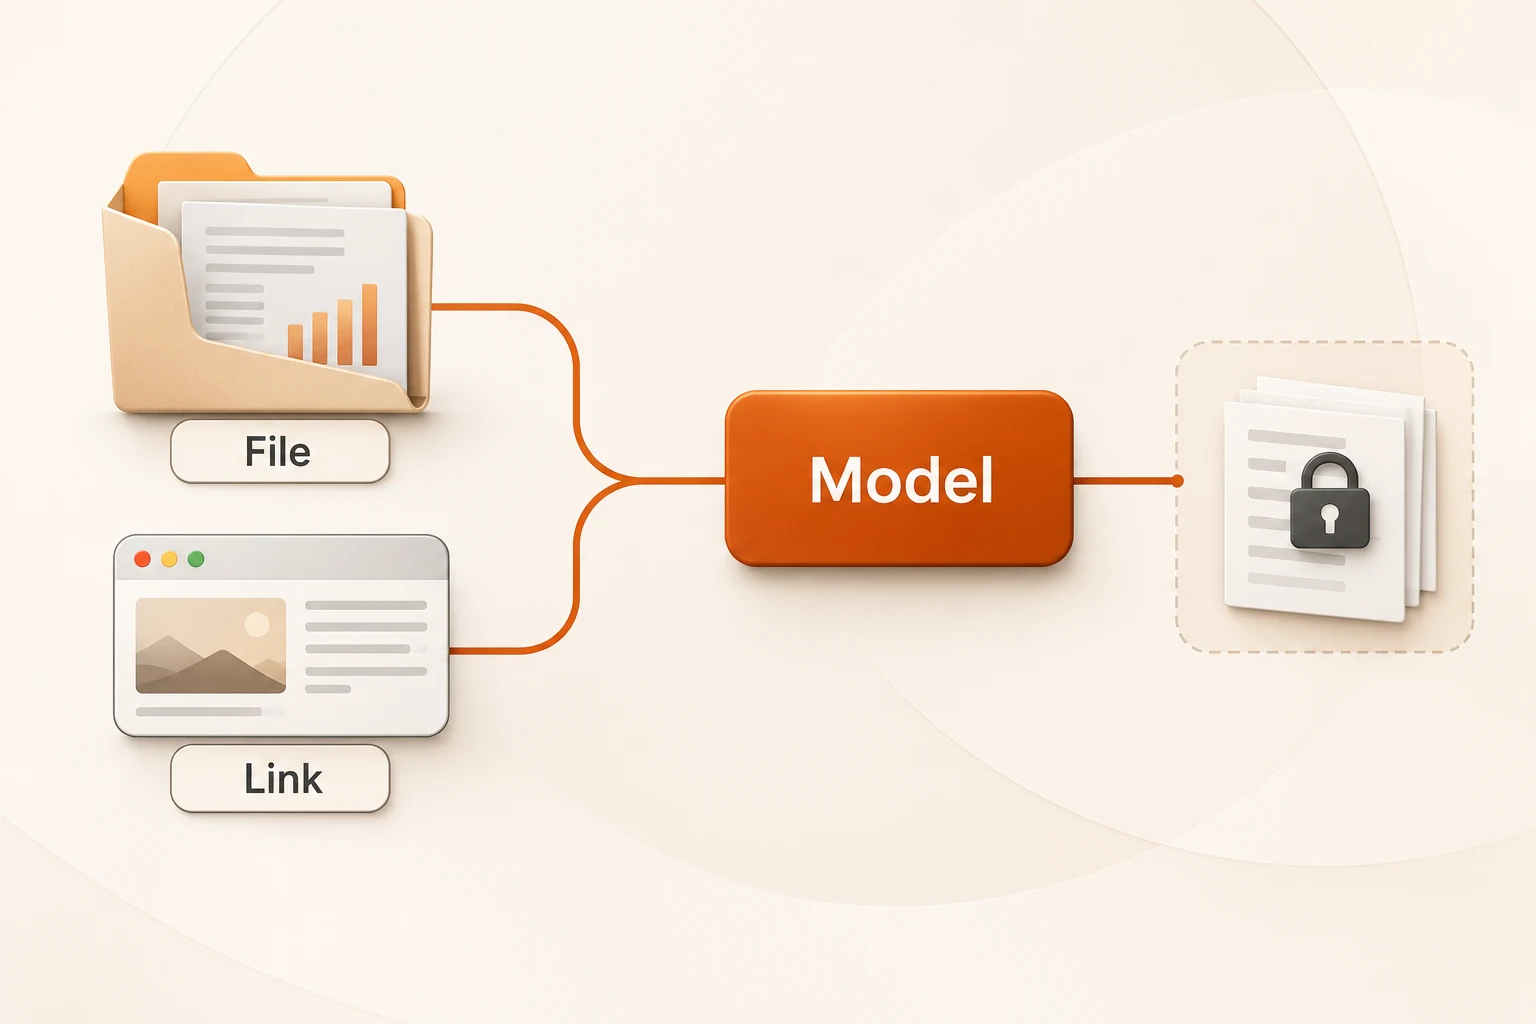
2026 年 11 月 13 日,DeepSeek 把网页端和 App 里的几项对话能力开放给 API:联网搜索、深度思考搜索、文件输入、阅读链接和模型内容安全。deepseek-flash 在 Messages、Responses 和 Chat Completions 三种协议下都能使用,搜索和抓网页由服务端完成。
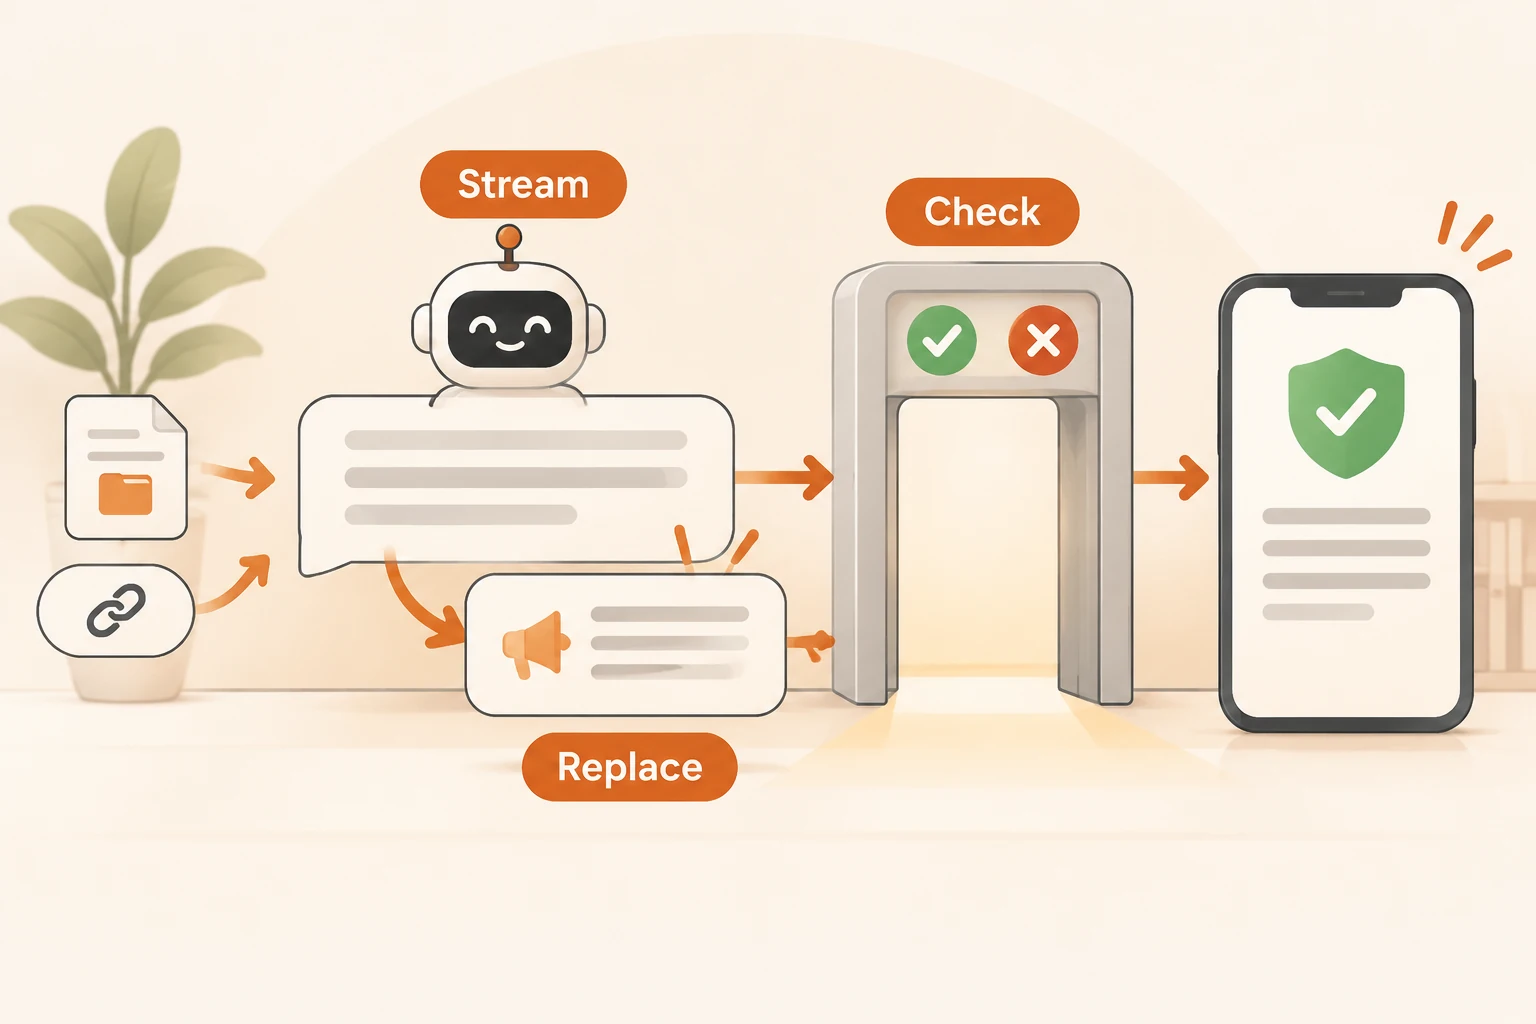
想用它做一个面向公众的聊天机器人时,最容易漏掉的是这一点:开启安全校验后,回答已经流式显示给用户,仍可能在最后被判为拒答。 前端需要能撤下已显示的内容。
本文于 2026 年 11 月 15 日核对 DeepSeek 的更新日志、构建 Chatbot、模型内容安全、文件解析和价格文档。没有用真实 Key 调用,没有触发拒答,文中的响应格式来自官方文档。下面讲的是 DeepSeek 官方 API;若经由网关转发,需另行确认 safety_check 等字段是否原样透传。
开启安全校验只要一个字段
{"safety_check": {"level": "high"}}
level 只能是 high 或 low,low 等于不传,是 API 默认的内容检查。开启后会审核用户消息、tool_result 等输入和模型输出。可以单独使用,也可以和联网工具一起用;单独使用时 tool_choice 只能是 auto 或 none。
DeepSeek 文档写得很直接:对外提供服务时请开启这个参数,但它不能替代服务提供者自己的内容安全审核、大模型登记、AI 标识等义务。开发者仍是内容安全的第一责任人。
拒答发生在流式结束之后
开启 safety_check 后,模型输出结束时连接不会马上关闭,服务端还会对完整输出再审核一次。审核期间连接保持打开,审核结果仍可能把这次响应改为拒答。
已经流式发给浏览器的文字无法撤回。所以前端要做到:
- 边收边显示,但把这段回答标为“待确认”。
- 收到结束标记后再判断是否拒答。
- 如果是拒答,删掉已显示的回答,换成你自己的提示文案;响应不会说明具体原因。
- 历史记录里也不要保留被撤下的内容。
三种协议的拒答标记不同,处理代码要按协议分别判断:
| 协议 | 拒答时 | 已执行的工具 |
|---|---|---|
| Messages | stop_reason 为 refusal | 保留工具块,补一个空 text 块 |
| Responses | status 为 incomplete,incomplete_details.reason 为 content_filter | output 只保留 web_search_call |
| Chat Completions | finish_reason 为 content_filter,content 为空字符串 | 保留 server_tool_calls,思考被清空 |
Chat Completions 的拒答看起来像“返回了空内容”。如果你的客户端把空 content 当成网络错误自动重试,会重复付费又得到同样结果;先看 finish_reason,排查方法见AI API 返回空内容。图片未通过审核时,说明会放在 refusal 字段里,指出是哪几张。
另外两点:没有开启 safety_check 但声明了联网工具的请求,也可能以拒答结束;若是输入未通过审核,请求直接返回 400 Content Exists Risk。
拒答也会计费
按文档:
- 拒答前已经消耗的 Token 照常计费。
- 安全审核本身产生的 Token 按输出计费,单独列在
usage的safety_tokens(Chat Completions 为usage.completion_tokens_details.safety_tokens)。 - 输入未通过审核返回
400时,输入 Token 仍按缓存命中价计费。
deepseek-flash 当前价格分时段:工作日北京时间 9:00–12:00、14:00–18:00 为高峰,输入(未命中缓存)每百万 Token 2 元、输出 8 元;其他时段减半。联网搜索和网页抓取另按每 1,000 次 5 元计费。记账时把 safety_tokens 与普通输出分开记录,月底才看得出审核带来多少额外支出。
开启联网工具、safety_check: high 或会话标题时,temperature、top_p、stop、seed、n 等参数会被服务端忽略(各协议列表不同)。max_tokens 仍有效,但限制的是每一步推理的输出,不是整轮总输出。
文件上传要等解析完成
文件输入分两步:先上传到 Files API 并指定解析方式,拿到 file_id 后在对话里引用。
curl https://api.deepseek.com/files \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -F purpose="text_recognition" \
  -F file="@report.pdf"
几个会影响实现的细节:
purpose必须写在file前面,否则返回400。OpenAI Python SDK 默认先发表单字段,无需处理。- 上传接口会等解析完成才返回,期间不发送任何数据。上传限时 120 秒,解析限时 120 秒;客户端和中间代理的超时要按两者之和设置。
- 客户端断开不会取消解析。 解析成功的文件照常保存并按页计费(每 1,000 页 1.5 元),之后可在
GET /files里找到,不要盲目重新上传。 text_recognition只给文字,图表会被丢弃;需要模型看图时用rich_layout_recognition,裁出的图会占输入 Token 和每请求图片数上限。- 引用后的文档会一直在上下文里。 多轮对话中历史消息引用的文档内容完整保留,每一轮都按输入计费;超长时返回
400,不会静默截断。每请求最多 20 个文档、文字合计 8 MiB。
上传、两种解析方式和读链接的完整流程,见DeepSeek API 现在能直接读文件和网页吗。原始文件和解析结果都不支持下载,你自己的系统需要保留原件。纯文本、表格和电子书用 purpose: user_data 上传,不计解析费。需要回答带出处时,引用如何对上原文可参考PDF 问答的引用链;只做搜索与抓取研究,见DeepSeek Search & Fetch。
演示客户端不能直接上线
DeepSeek 开源了一个演示客户端,API Key、历史对话和图片都存在浏览器本地,官方说明“仅供演示”。对外服务时,Key 要放在你自己的后端,由后端转发请求、记录用量并处理拒答,不要把 Key 交给访客的浏览器,原因见API Key 安全保存。
上线前可以用这份清单自查:
- 前端能在收到拒答标记后撤下整段回答,并替换为提示。
- 空
content不会触发自动重试。 - 日志区分
safety_tokens、搜索次数和文件解析页数。 - 上传请求的超时至少覆盖 240 秒(上传加解析)。
- 登记、AI 标识等合规义务由你的团队另行完成。