Gemini 批处理结束了,先逐条对账再补跑
Gemini Batch API 的作业完成不等于每条请求成功。用稳定 key 保存输入与结果,区分错误、缺失和待审核项,避免创建请求重试导致整批重复执行。
Gemini Batch API 适合不必立即交付的摘要、分类与离线评估。官方说明,其费用为相应模型标准交互费用的 50%,目标完成时间为 24 小时。但作业显示完成,并不代表每条业务记录都有可用答案。
把批处理接进工作流,最先要做的是保存输入清单和作业名,完成后按 key 对账。明确失败的项再判断是否补跑,成功结果保留,缺失结果先查原因;不要看到一个错误就把整批重新创建。
本文于 2026 年 11 月 19 日核对 Batch API 指南的输入文件、作业状态、结果处理与最佳实践。没有提交真实批处理,以下 JSONL 与对账记录都是公开合成例子,不提供任务耗时或节省金额的实测。
为什么同一个作业里会有成功和失败?
Batch 是把多条请求异步安排到一个作业里,不是一个保证整体成功或整体回滚的数据库事务。官方要求作业完成后检查 batchStats.failedRequestCount,文件输出还要逐行判断是模型响应还是对应请求的错误。
当前指南明确:此功能使用 generateContent API,不要把 Interactions 的请求体直接写进批处理文件。支持哪些模型与模态要查各模型页面;交互调用支持某个工具,也需要确认该批处理路径的具体限制。
输入可以直接内联,小批量总请求体保持在 20MB 以下;更大的任务可用 JSONL 输入文件,单个文件上限为 2GB。24 小时是官方的目标周转时间,不是你的业务必须准时完成的承诺。急着给在线用户回复的流程,应保留同步路径。
一条输入该留下什么标识?
JSONL 每行包含自定义 key 和一份完整请求。选择能回到业务记录的稳定标识,把文档版本、提示版本与模型另存到本地清单,不把姓名或邮件等隐私直接塞进 key。
下面保存为 requests.jsonl,两行都是公开教学素材:
{"key":"demo-a-v1","request":{"contents":[{"role":"user","parts":[{"text":"用一句话概括:这是一份介绍公开公园开放时间的演示说明。"}]}]}}
{"key":"demo-b-v1","request":{"contents":[{"role":"user","parts":[{"text":"用一句话概括:这是一份介绍公开图书馆借阅规则的演示说明。"}]}]}}
官方会在结果中带回 key,用它匹配原请求。不要把“输出第 10 行”当作“输入第 10 行”的业务标识;按 key 建立映射也便于处理遗漏、重复下载和后续补跑。
以下为官方 SDK 的文件提交形状,需要本地 GEMINI_API_KEY。示例没有执行。运行前先保存清单并确保只有一个提交者;提交成功后立即保存 job.name。
from pathlib import Path
from google import genai
from google.genai import types

client = genai.Client()
uploaded = client.files.upload(
    file="requests.jsonl",
    config=types.UploadFileConfig(
        display_name="public-summary-input-v1",
        mime_type="application/jsonl",
    ),
)
job = client.batches.create(
    model="gemini-4-hydrogen",
    src=uploaded.name,
    config={"display_name": "public-summary-v1"},
)
Path("batch-name.txt").write_text(job.name)
print(job.name)
这段代码展示提交形状,不是可反复运行的恢复脚本。官方明确说明创建作业不具备幂等性:同一创建请求发送两次会生成两个作业。若提交结果不明,或服务接受后本地写文件失败,先核对服务端记录,不直接重跑 batches.create。display_name 只是便于识别的名称,不是防重复提交的保证。
作业成功后,怎么找出真正需要处理的项?
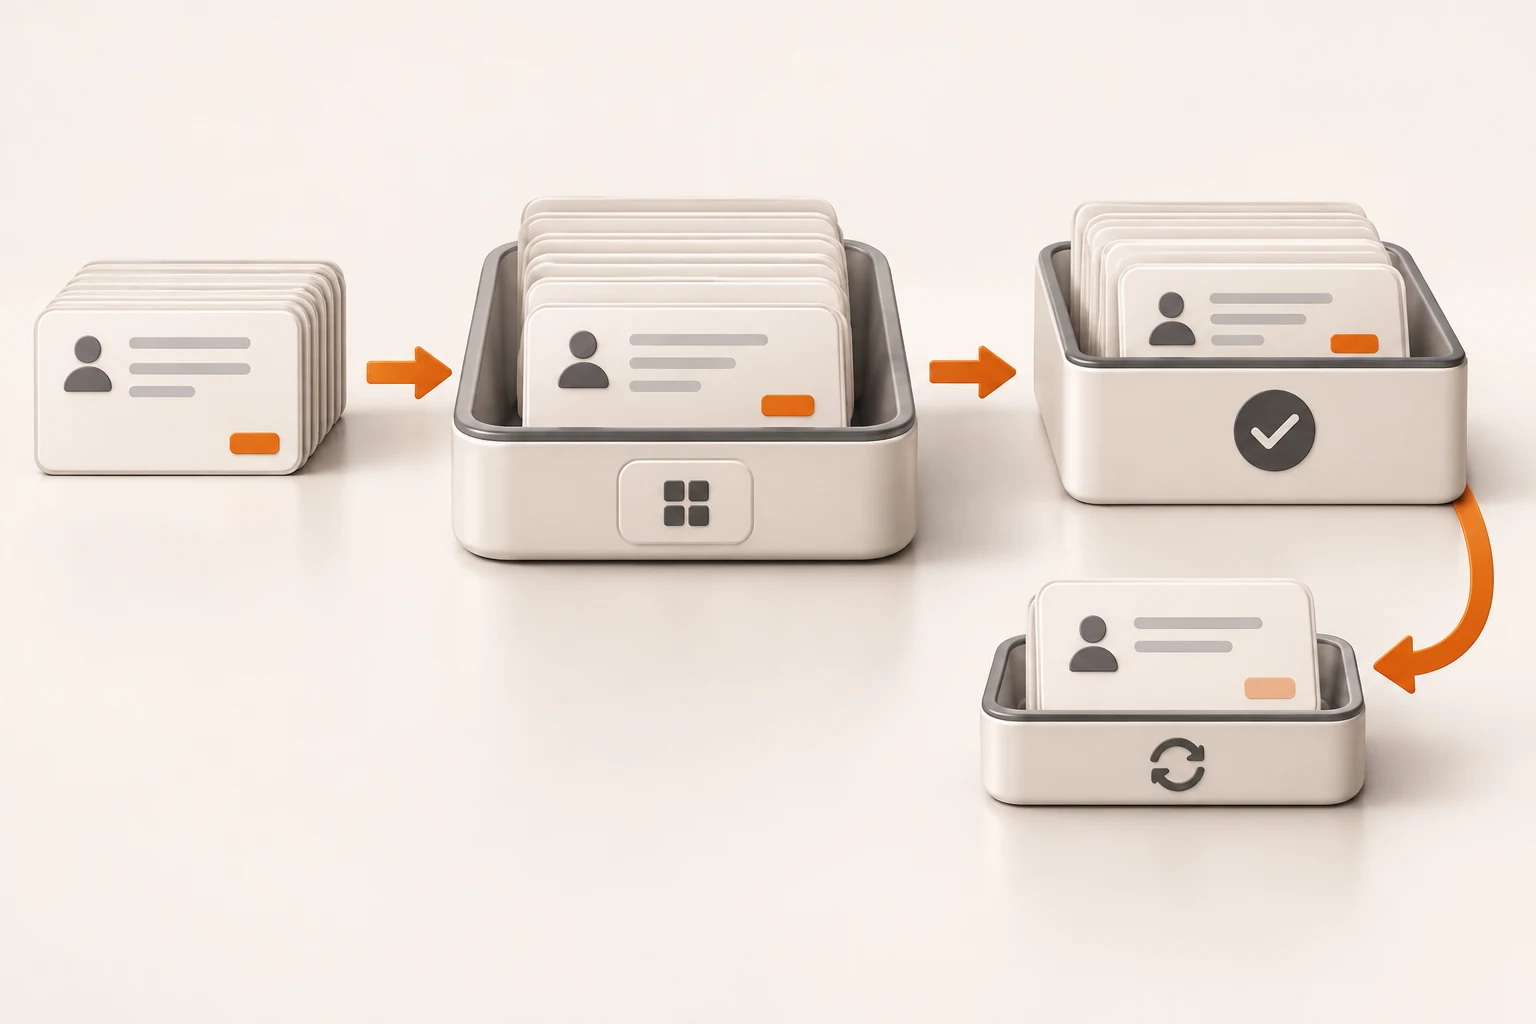
先保存原始输出文件,再分开处理四类:有模型响应、明确错误、没有出现的 key、出现了但业务验证不通过的结果。
下面只完成结构对账,输入是原来的 requests.jsonl 与下载后的 results.jsonl。它拒绝重复或陌生 key;“有响应”仍需要检查安全反馈、结束原因、空答案与业务字段,不能直接标为交付完成。
import json
from pathlib import Path

inputs = [json.loads(line) for line in Path("requests.jsonl").read_text().splitlines() if line.strip()]
expected = {row["key"] for row in inputs}
if len(expected) != len(inputs):
    raise ValueError("Duplicate input key")
seen, response_keys, error_keys = set(), set(), set()
for line in Path("results.jsonl").read_text().splitlines():
    if not line.strip():
        continue
    row = json.loads(line)
    key = row["key"]
    if key not in expected or key in seen:
        raise ValueError(f"Unexpected or duplicate result: {key}")
    seen.add(key)
    if row.get("response") is not None and row.get("error") is None:
        response_keys.add(key)
    elif row.get("error") is not None and row.get("response") is None:
        error_keys.add(key)
    else:
        raise ValueError(f"Unrecognized result structure: {key}")
print("Needs content validation:", sorted(response_keys))
print("Inspect errors:", sorted(error_keys))
print("Missing, investigate first:", sorted(expected - seen))
缺失项不自动等于失败项。先确认作业已到终态、下载完整、读的是正确文件;如果结果文件损坏,重新下载同一结果比重建整批更合适。已经有响应但内容不合格的项,保留原答案和原因,再决定调整提示还是人工处理。
什么时候补跑,什么时候继续等?
官方状态包括 JOB_STATE_SUCCEEDED、JOB_STATE_FAILED、JOB_STATE_CANCELLED 和 JOB_STATE_EXPIRED 等。轮询失败不等于作业失败,应拿已保存的作业名继续查询;作业进入终态后,再按实际可取得结果对账。
对明确失败的单项,先区分能否通过重试解决:模型或参数不合法先修输入,暂时服务错误才考虑退避补跑。建新作业时只装入经过判断的补跑项,另存新的作业名和尝试记录。业务记录可以保留原 key,尝试编号放在本地清单中,避免把原始成功结果覆盖掉。
取消也需要等状态确认,不能把“已发送取消请求”当作所有记录都从未处理。模型结果后面若接邮件、订单或数据库写入,还要独立防止业务动作重复;可参考n8n 的副作用恢复。
哪些工作适合先迁到 Batch?
先挑可以容忍等待、输入固定、输出能单独验收的工作,例如每天整理公开资料、批量生成候选摘要。不要把 24 小时目标塞进必须几秒内响应的客服流程,也别假设 Batch 自动消除了多层重试的风险。
带状态的任务可沿用自动化工作流的节点分工:准备、提交、查询、对账、发布各自保存结果。查询与下载失败时接着原作业做,发布失败时接着已保存的模型输出做,恢复位置才不会退回整批起点。
通过 Nbility 接入前,查Gemini 原生兼容文档并另核 Batch、Files 与结果下载能力。本篇只介绍 Google 官方流程,未验证这些异步资源能经过本站转发;普通对话接口可用不构成 Batch 支持证明。