Gemini 转写开始听懂“把上一句改掉”
Gemini 3.5 Transcribe 的 Smart 模式加入语音编辑,可以改写已有 source_text。做录音输入时要区分逐字转写、整稿替换和多轮状态,确认修改后再保存或发送。
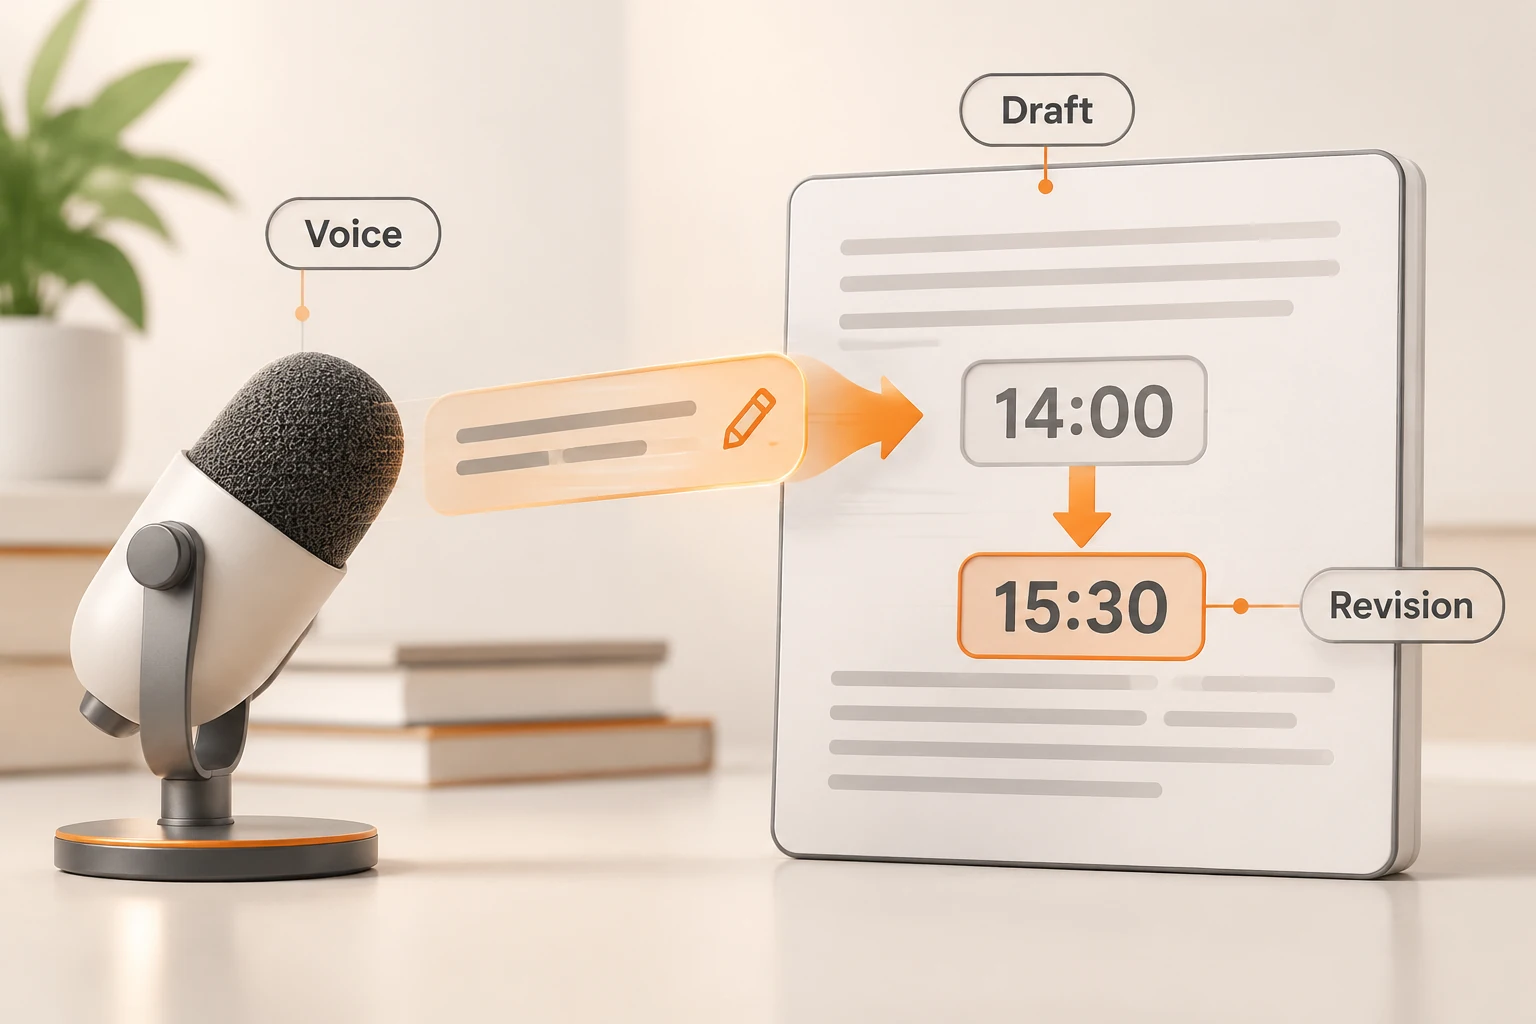
说完“会议明天下午两点开”,再补一句“改成三点半”,转写工具可以直接交回修改后的稿子。Google 在 2026 年 11 月 17 日为 gemini-3.5-transcribe 和 gemini-3.5-transcribe-live 加入语音编辑,支持修改词语、调整语气、整理格式,以及编辑已有文本。
这适合口述写作和表单草稿。需要逐字保留证词、采访或原始会议记录时,则要继续使用逐字转写,避免把说话里的“修改指令”执行成稿件变更。
本文于 11 月 19 日核对发布记录及语音编辑指南。没有上传录音或测量中文识别效果,以下场景与验收语句均为演示设计。
Smart 模式和普通转写有什么不同?
普通转写主要回答“刚才说了什么”,语音编辑回答“按照刚才的要求,这份文字现在应该是什么”。官方 API 默认是逐字转写;设为 mode: "smart" 后,语音编辑默认启用。
| 需求 | 更合适的处理 | 应保存什么 |
|---|---|---|
| 原样记录采访与会议 | 逐字转写 | 原录音与原始转写,另存整理稿 |
| 边说边改一段文字 | Smart 模式 | 修改前版本、完整新稿与确认状态 |
| 用语音改已有公告 | Smart 模式加 source_text | 输入稿版本与本次新稿 |
一次把“不要修改,只记录这句话”说给 Smart 模式,是否完全按你的预期处理,仍需实测。对必须原样留存的内容,应在产品里明确选择逐字模式,而不是只靠口头约束。长会议的分段与时间戳是另一件事,可读长音频时间线还原。
怎么让它修改一份现成的稿子?
把既有文字放进 transcription_config.mode.source_text,同时把 mode 写成包含 type: "smart" 的对象。官方限制 source_text 最多 64 KiB,也就是 65,536 字节;这是字节数,不是汉字数。
下面沿用官方 Python SDK 的请求结构。先在本地配置官方 GEMINI_API_KEY,准备一段只包含公开演示指令的音频,例如“把时间改成三点半,补一句支持视频参会”。示例未执行,也不预设真实输出。
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})
audio = client.files.upload(file="edit-command.mp3")

response = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[{
        "type": "audio",
        "uri": audio.uri,
        "mime_type": audio.mime_type,
    }],
    generation_config={
        "transcription_config": {
            "mode": {
                "type": "smart",
                "source_text": "会议明天下午两点在 42 号楼举行。",
            }
        }
    },
)
print(response.output_text)
官方语言表包含普通话 cmn-Hans-CN 和粤语 yue-Hant-HK 等,但“支持语言”不等于特定口音、专名与含糊指令一定识别正确。先用同一组公开短句检查时间、数字、否定词和保留内容。
返回内容要追加,还是替换?
语音编辑返回的是完整更新稿。如果原稿是三句话,指令只改第二句,返回值仍应当作为一份候选整稿来展示。把它直接追加到原稿后面,容易出现原文与新文重复;把增量事件逐块当作完成稿,又可能覆盖成半句话。
更清楚的界面流程是:保留当前稿,拿到完成结果后显示新稿与差异,用户接受后再更新保存版本。这里的“接受后保存”是应用设计建议,并非模型自动提供的版本管理功能。
同样,稿件里出现“发给全体同事”,只说明文本或指令里有这句话。转写结果不应自动触发邮件、群发或提交表单;外部动作需要应用自己的明确确认。涉及工具写入的边界,可参考读取结果与写操作权限。
第二轮会记得第一轮的修改吗?
独立的 interactions.create 调用不会自动保留上一轮的 source_text。按官方指南做连续编辑时,需要把上一轮返回的 output_text 作为下一轮的来源文本。
在带人工确认的编辑器里,更稳妥的是传入“上一轮已经接受的稿子”,并记录它的版本。例如,编辑请求基于 draft-v3 发出,等待期间用户又手动改成 draft-v4,收到结果后就应提示比较或重新编辑,不能无声覆盖 v4。
官方另说明,Live API 的双向会话在 Smart 模式下会自动把每轮最终转写更新为活动来源文本;其模式值写作 SMART。这是持续会话的行为,不应套给上面的独立请求。本文未运行 Live 会话,也不把两套配置混在一个示例里。
怎样验收它确实改对了?
先写好“允许改什么、必须保留什么”,再录指令,比只听一个顺耳的结果更容易发现问题。
可以用下面这组公开测试设计,不把它当成已取得的模型结果:
- 原稿有时间、地点、联系人,要求只改时间;核对其余字段是否保持。
- 要求删第二句,再问“撤回刚才的删除”;检查应用是否保留旧版本,别假设模型自带撤销历史。
- 第一轮把 14:00 改成 15:30,接受后再做第二轮;确认传入的是新稿而非初稿。
- 用户在请求期间手动改稿;确认旧请求的结果不会覆盖新版本。
只需要“录完一段短音频,转成文字供用户确认”的输入框,也可以先对照DeepSeek 短录音识别路径,不用为了基础输入就引入连续编辑状态。
通过 Nbility 接入时,先查Gemini 原生兼容说明。本文没有验证本站是否提供 Google Transcribe、Files 或 Interactions 路径;能调用普通 Gemini 对话,不能据此认定语音编辑端点可用。