Gemini Omni 1.2 让视频创作可以接着改
Gemini Omni 1.2 Flash 支持对话式视频编辑,但生成、首尾帧和延长有不同限制。用一段商品镜头的创作计划理解状态续接、素材和验收。
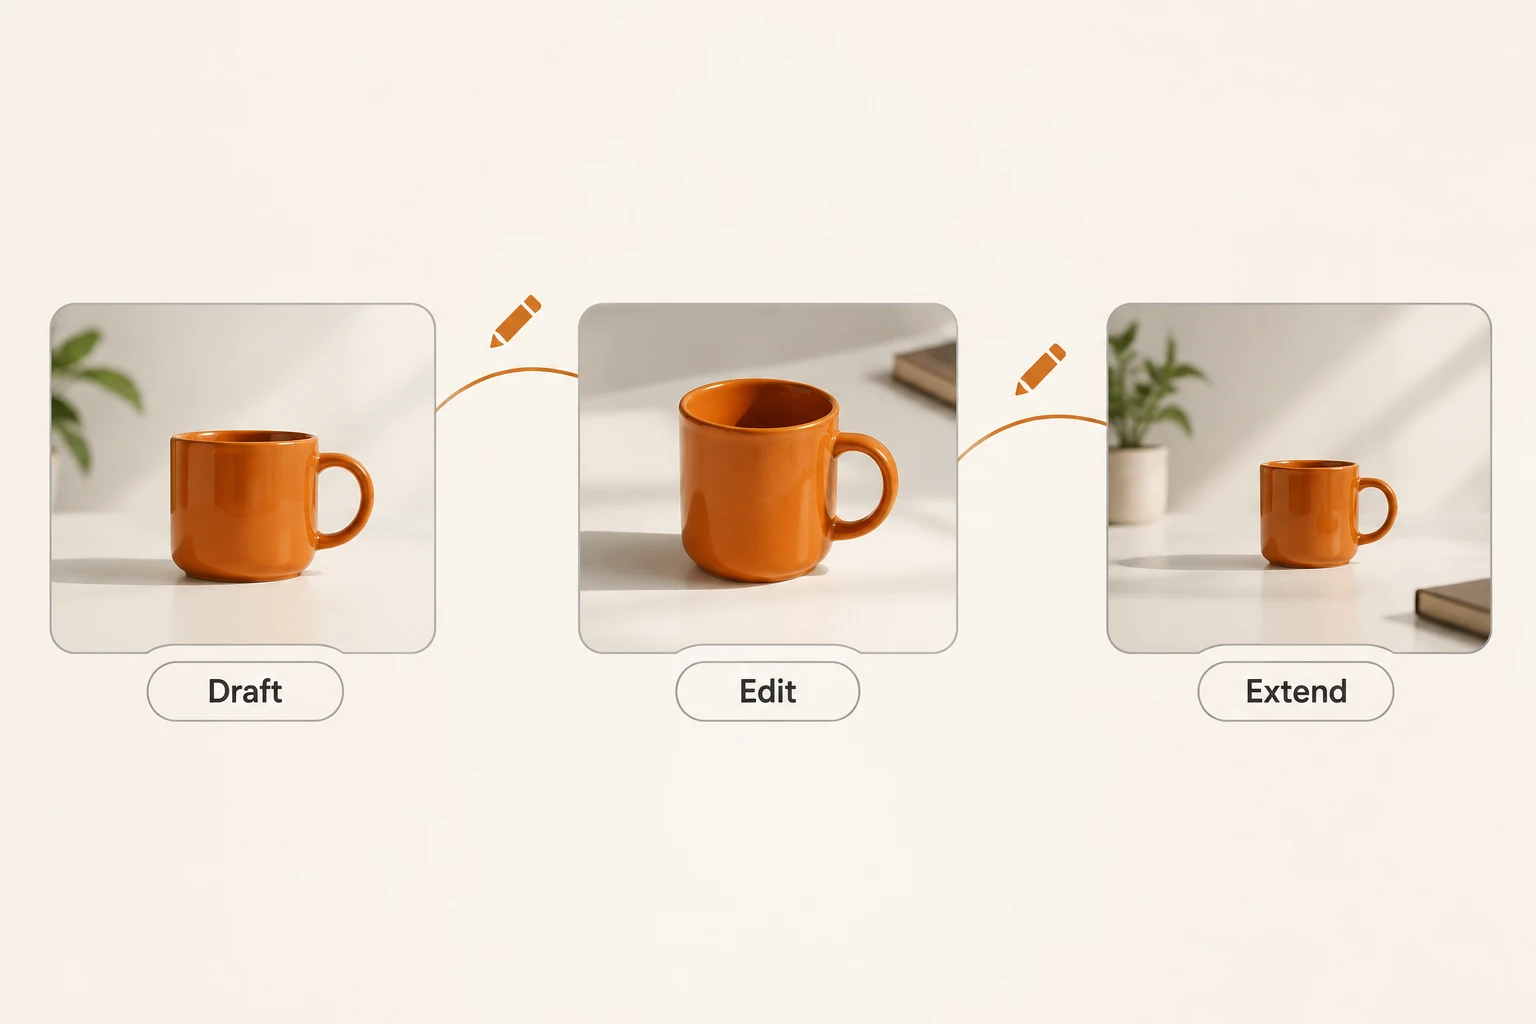
视频生成最让人犹豫的一步,经常发生在第一版之后:主体和动作已经合适,只想换个背景或接一个结尾,要不要把整段重新描述一遍?
11 月 5 日正式开放的 Gemini Omni 1.2 Flash,把这类工作放进了可连续修改的流程。它可以通过自然语言编辑已有结果,也支持把短片往后延长。不过,“能接着改”仍有状态、模式和素材条件,不能把所有视频请求都当作同一种操作。
本文于 2026 年 11 月 11 日核对 Gemini 更新记录、模型页与完整视频指南。下面是基于文档设计的创作计划,没有实际生成或编辑视频;封面与正文图均为说明图,不是模型输出样片,也没有延迟或效果测试。
三种时长,分别对应三种操作
当前模型 ID 为 gemini-omni-1.2-flash。官方模型页列出视频与原生音频输出、对话式编辑以及最高 4K 输出等能力;具体操作还要按模式核对。
| 操作 | 当前文档的时长范围 | 需要特别留意 |
|---|---|---|
| 生成新视频 | 3–15 秒 | 不能把这个上限套给首尾帧插值 |
| 同时给首帧与尾帧做插值 | 3–10 秒 | 两张图指定起点和终点,并非任意长视频编辑 |
| 往后延长视频 | 每轮追加 3–10 秒,总长最多 30 秒 | 只能接在末尾;不能往开头或中间插入 |
指南还允许编辑不超过 15 秒的输入视频。30 秒是延长后的总长上限,不表示可以上传任意 30 秒成片再做同样的编辑。
需要把多段剪成更长视频、精确调整中间帧或处理字幕轨时,仍要考虑常规剪辑工具。先决定这一步要生成、修改还是延长,提示词与接口才有明确目标。
把一段商品镜头分成三次决定
假设要为一只自有设计的陶瓷杯制作短片。可以先准备同一主体的正面与侧面参考,确认自己有素材使用权,再写一段简单动作。以下是提示词草案,不代表模型已经按要求生成:
初稿:生成一段 6 秒镜头。白色桌面上的橙色陶瓷杯,
镜头从正面缓慢移向右侧。保留杯把形状和杯身比例,
背景简洁,不添加文字。

修改:沿用刚才的视频,只把背景换成柔和的浅灰色。
杯子的形状、位置和镜头运动保持不变。

延长:在末尾追加 4 秒,镜头缓慢停下。
杯子仍在同一张桌面上,不引入新物体。
这样的拆分有两个好处:第一版先判断主体和运动是否可用;后面每次只改变一个清楚的条件。验收也可以逐轮进行:杯把有没有改变、桌面关系是否连贯、追加片段的交界是否跳动、音轨是否出现不需要的内容。
文档称 1.2 最多支持 6 张参考图片,但数量上限不是要求。不同角度却互相矛盾的图片,可能让你更难判断失败原因。可以先从少量一致素材开始;如果要先做分镜静帧,参考图片 API 文档,再按图片保存流程保存原始素材。
接着说一句话,需要保留什么
官方的有状态编辑示例使用 Interactions API 的 previous_interaction_id,把下一轮修改关联到上一轮结果。它承担的是服务端上下文引用,不能简单替换为本地视频文件名或“刚才那段”的文字。
需要连续编辑时,应把每轮交互标识、提示词、输出和版本关系保存在自己的私有任务记录中。选中了第二版后,后续修改要引用对应版本,避免回到第一版继续分支却误以为改动丢失。
还有一个容易忽略的配置:指南把 store=false 列为同步生成的性能选项之一,同时明确指出,关闭存储后,不能再用 previous_interaction_id 编辑该次生成的视频。 如果工作目标就是下一轮修改,不能不看条件就复制这一项。
界面或兼容服务只提供一次视频生成,也不证明它提供了这套状态续接。本站目前的 MiniMax H3 文档描述的是另一套模型与任务接口,不能把 Omni 的交互字段或限制直接粘到其中。要使用官方 Omni 的连续编辑,先确认所选服务实际覆盖的协议和账号权限。
延长视频时,模型主要看最后十秒
官方指南说明,延长时使用输入视频的最后 10 秒作为上下文,保留更早的画面。如果某个角色或物体只在更早的部分出现,后续提示应重新说明,必要时提供参考图片。
这会影响实际创作顺序。开头出现的商品标记或角色特征,不能假定延长时仍被完整记住。分轮创作前,可以先写一份短的连续性说明,列出主体、服装或形状、场景和运动方向;每次只带与当前镜头有关的要求。
音频也要单独看:输出原生音频,不表示当前接口支持上传音频参考、修改音色或任意续写上传视频中的对白。指南明确列出音频输入和参考不支持、声音编辑不支持;上传视频与模型原生视频的对白延长条件也不同。
此外,上传视频的编辑和延长在欧洲经济区、瑞士和英国受限,模型生成视频的可编辑范围则按官方说明另行判断。地区、素材和账号限制都应在制作前检查,不能由模型名称推断。
第一版值得留下,再继续下一轮
对一段短片,先定几项具体的通过条件:主体一致、动作完成、没有多余元素、所需声音正确、片段交界可接受。每轮保存实际文件和版本关系,失败时回到一个已确认的版本;提交结果不明时先查询现有任务,不要连续重建。
官方还公告 gemini-omni-1.1-flash 将在 12 月 3 日自动路由至 1.2。本文写作时这项未来调整尚未生效;使用旧名称的应用应核对模型名与实际能力,在生效前安排验证。
准备接入 Nbility 时,先从模型目录与 ID 说明确认当前实际服务,再查对应模型的接口文档。把生成、编辑和延长逐一验证,才能知道这条创作链路是否真正可用。